千卡级 NVIDIA GPU 集群设计指南(IDC 部署视角)
场景假设:你要在 IDC 里落地一套 1024 卡(128 节点 × 8 卡) 的 NVIDIA GPU 集群,
跑大模型训练(DP/TP/PP/EP 混合并行)+ 推理。本文讲清楚:交换机怎么选、多轨(rail)
怎么布、网络容量怎么算、以及 K8s/调度要配合什么。数字基于 DGX/HGX 形态 + H100(NVLink 900GB/s、400G NIC),代际差异会注明。
1. 先定边界:这三张网络各司其职
一个大模型集群不是一张网,是四张互相隔离的网络(俗称 4 平面):
| 网络 | 用途 | 流量特征 | 建议 |
|---|---|---|---|
| 计算网络(后端) | GPU 跨机通信(NCCL/RDMA) | 高带宽、突发、对延迟敏感 | IB NDR 400G 或 RoCE 400G,无收敛(1:1) |
| 存储网络 | 训练数据/CKPT 读写 | 高带宽、大流向 | 以太网 100G-400G,可收敛 4:1 |
| 管理网络 | BMC/IPMI/SSH/监控 | 低带宽 | 万兆以太网足够 |
| 前端/业务网 | 推理 API、登录 | 多变 | 以太网按需 |
核心原则:计算网络与其它网络物理隔离(独享 IB 网卡+交换机)。
混用管理网跑 NCCL 是你把集群搞慢的头号原因。
千卡规模的两大用料估算:
- 128 节点 × 8 网卡 = 1024 个 400G 端口(计算网)
- 如果推理/存储也要 400G,端口数会翻倍 → 交换机数量按端口算(见 §4)
2. 拓扑选型:为什么是”多轨(Rail)+ 两层(Leaf-Spine)”
2.1 从 Fat-Tree 到 Rail-Optimized
传统高性能计算用 Fat-Tree(胖树):每个节点随机连到不同的 Leaf 交换机,
Leaf 之间通过 Spine 全互联,任意两点都能到达(有等价多路径 ECMP 负载均衡)。
但 GPU 训练有个 Fat-Tree 解决不了的问题:AllReduce 在任意一刻,同一个 GPU 要和
“它对应编号的兄弟”通信(比如 rank 8 和 rank 24 循环搬运)。胖树的随机连接导致:
- 通信对分布不均匀 → 某些 Leaf 承载了大量流量(热点)
- 跨 Leaf 的通信要绕 Spine → 时延变长
Rail-Optimized(多轨优化) 的思路:把”同轨道的兄弟”放在同一台 Leaf 下。
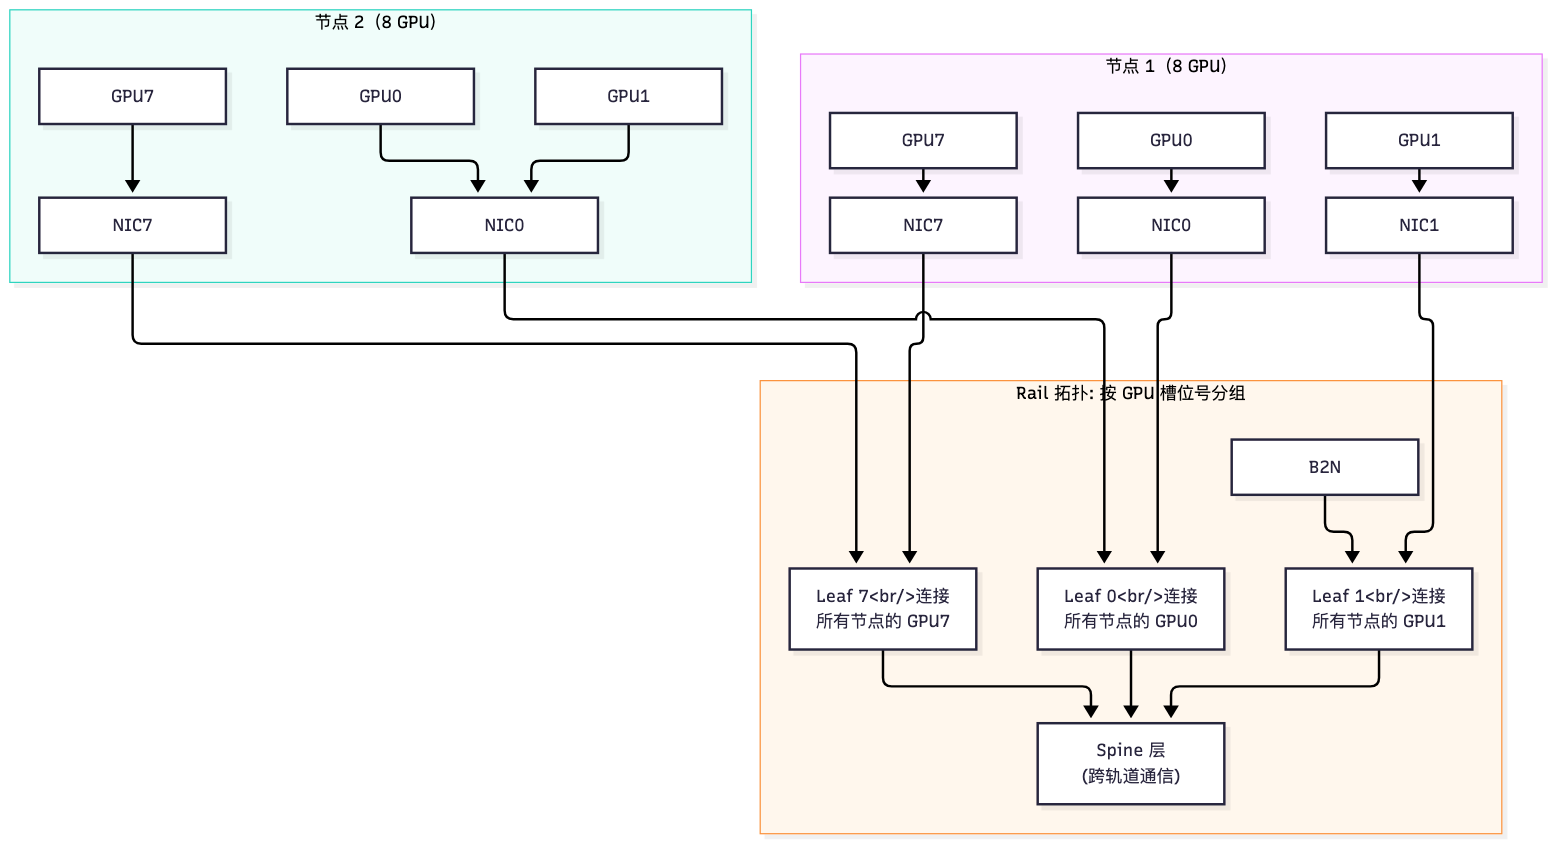
多轨定义:每台节点第 k 张 GPU 的网卡都连到同一台 Leaf(叫 rail k)。
128 个节点 → 每 rail 有 128 个端口 → rail 0 覆盖所有节点的 GPU0,rail 1 覆盖所有 GPU1……
8 张卡 / 节点 → 正好 8 条 rail。
2.2 多轨的两个直觉收益
- 同规格通信流量天然均匀:AllReduce 时所有 rank 的 GPU_i 同时发数据给对应 rail——
每个 rail 内部流量自洽,不经过 Spine → 每个 rail 都是局部化满带宽。 - 故障域清晰:某一个 Leaf 坏了,只影响它的那条 rail(比如 GPU0 的数据通不了,
但是 GPU1-GPU7 完好)→ 排障和带宽降级可控。
2.3 规模上不来时怎么办:块(Block)/ 单元(SU)
真正 1024 卡以上,你不可能一张图全连。NVIDIA 的 DGX SuperPOD 引入 SU(SuperPod Unit):
- H100 SuperPOD:每个 SU = 64 节点(512 卡),rail 拓扑内部 1:1 无损
- 64 节点 × 8 rail = 64×8=512 端口,用 8 台 64 端口 Leaf(如 QM9700 64×NDR)+ Spine 组内互联
- 多个 SU 之间再加一层 Spine,跨 SU 通信会多一点跳数(带宽>90% of intra-SU)
(注:NVIDIA 官方 SU 数字随代际变,H200/GB200 的 SU 规模不同;你设计时记住
“同 rail 内 1:1、跨 rail 有收敛” 的分层哲学即可,也可以自定义 Block=64卡 起步。)
3. 交换机怎么选:看端口 × 带宽,不是看品牌
3.1 三类交换机角色
| 角色 | 典型设备 | 端口/带宽 | 用途 |
|---|---|---|---|
| Leaf(接入/轨道) | NVIDIA QM9790(64×NDR400)等 | 64×400G = 25.6 Tbit/s | 收 rail 内节点流量,1:1 |
| Spine(核心) | 同款大端口交换机 | 负责 Leaf 间流量 | 跨 rail 通信,可 2:1 收敛 |
| 存储网交换机 | 以太网 100G/400G | 收敛 2:1~4:1 | 存储/训练数据 |
3.2 关键选型参数
- 端口速率代差:EDR 100G → HDR 200G → NDR 400G → XDR 800G(2025 起)
- 400G 网卡 ↔ 400G Leaf 端口 → 带宽不缩水(1:1 无收敛)
- 别用 200G 交换机接 400G 卡(会降到 200G 但只花一半钱——取决于预算)
- 端口密度:64 口(NDR) vs 40/32 口 → 决定 rail 能覆盖多少节点
- 每 rail 节点数 = 交换机端口数 - 上行口数;64 口 Leaf 上行到 Spine 后约剩 56 口 → 56 节点/rail
- 1024 卡需求:128 节点 ÷ 56 ≈ 3 条腿不全 → 建议 128 节点用 2 个 64 节点 SU 更干净
- 缓冲与无损:RDMA 无损需要 PFC/ECN;交换机必须支持无损以太网(RoCE)或原生无损(IB)
- 网内计算:SHARP/Gen-AI Switch(IB 交换机内置归约引擎)→ AllReduce 卸载更省网络带宽
(NCCL 的 NVLS 只能在机内 NVSwitch;跨机的网内归约靠 SHARP)
一个容易犯的错:以为”交换机会自动负载均衡”。ECMP 按流哈希,一个大 AllReduce 就是几十条大流,
哈希不均 → 一条链路过热另一条空闲。IB 的自适应路由(AR)能缓解,以太网要自己调 ECMP 或换让更均匀的方案。
4. 网络容量计算:从”要多少带宽”到”买多少交换机”
4.1 训练通信量估算(容量规划的起点)
跨机通信最大头 = DP 梯度 AllReduce。每步通信量:
1 | AllReduce 数据量 = 模型参数量 × 每个参数的字节数 |
4.2 收敛比(Oversubscription)与预算权衡
| 设计 | 收敛比 | 带宽保障 | 成本 |
|---|---|---|---|
| 全 1:1(Leaf-Spine 全无收敛) | 1:1 | 任意时刻全部通信满速 | 最贵(Spine 台数翻倍) |
| 计算网 1:1、存储 4:1 | 混合 | 训练无瓶颈;存储突发让路 | 推荐 |
| 全套 2:1 | 2:1 | 高峰期打 7-8 折 | 省一半 Spine |
结论:计算网络必须 1:1(训练对带宽最敏感);存储网络 4:1 合理;管理网络万兆随意。
4.3 交换机数量速算(1024 卡 IB 方案)
1 | 每个 Leaf(64口 NDR):接 56 个节点上行 + 8 个上行到 Spine |
5. 多轨布线细节:节点内部怎么排
5.1 布线的铁律
- 每节点 8 卡 → 8 个 400G+ 网卡(每 GPU 一张),不要共享网卡(那是推理贫民方案)
- NIC 要与 GPU 在同 PCIe 域/同 NUMA(GPU Direct RDMA & 局部 PCIe 带宽)
《HGX 主板》下——否则跨域通信慢一半 - 节点 k 号 GPU 的 NIC → 固定接到 rail k 的 Leaf
- 机柜内:同 rail 的 8 张卡分插 8 台不同 Leaf 的上行口(或 4 台 Leaf 每口 x2,看拓扑)
1 | 节点 128 台,每台 GPU0..GPU7: |
5.2 需要注意的”隐藏坑”
- CUDA 感知网络:
ibstat看到 Active 不代表 NCCL 在用它——看NCCL_DEBUG的net#通道 - Rail 与机柜对齐:若交换机机柜和计算节点柜物理分布不规则,光线太长、模块种类杂会引入额外损耗
- 光纤预算:NDR 400G 通常用 100G/400G 光模块 + 单模/多模;
光模块类型与距离匹配错
会导致 BER 高、NCCL 偶发超时——这是”换卡没用、换线就好”的经典案例
6. 超低延迟方案(进阶):GB200 NVL72 和 800G
如果你预算和建设周期允许,2024-2025 的新范式是机架级互联:
| 方案 | 规模 | 机内互联 | 跨机互联 |
|---|---|---|---|
| 传统 HGX 8卡机 | 8 卡/节点 | NVLink 900GB/s | 8×400G NIC |
| GB200 NVL72 | 72 卡/机架 | NVLink5 130TB/s(架内 NVSwitch 全互联) | 72×800G NIC 或 IB XDR |
| 意义 | 把”TP 只限机内”扩大成”TP 可限架内“ | 72 卡当一张超大 GPU | 跨架走 800G |
- NVL72 的 TP 域从 8 卡扩到 72 卡 → 大模型(400B)拆分更容易、KV cache 合并更高效
- 网络成本下降(机架内不再需要 RDMA 交换机,纯铜缆 NVLink)
- 但跨架仍要 IB/RoCE 800G,且NVLink 域内单点故障影响 72 卡 → 运维模型变了
你现在管理的是 K8s;NVL72 的”节点”语义从”一台 8 卡服务器”变成”一个 72 卡机架”,
调度器和故障域(failure domain)设计要同步升级。
7. 与 K8s/调度器的配合(这是你能直接落地的)
| 集群设计要素 | 调度/平台侧配合 |
|---|---|
| rail 拓扑 | 调度时应把 TP 组放同一节点(8 卡满的节点 → NVLink);DP 组可跨节点但其 GPU 编号对齐轨道 |
| 故障域 | 用 Pod 反亲和/拓扑约束让 job 避开坏 Leaf/坏 rail;坏一台 Leaf 只少 1/8 带宽 |
| NUMA/P2P 感知 | K8s Device Plugin 应暴露 GPU 的拓扑(NVLink 矩阵),调度器选”内部全互联”的 GPU 子集 |
| 网络监控 | Sniffer(gap/adaptive routing)、ibdiagnet、Cray/UFM Telemetry 持续盯 IB 健康 |
| 训练框架 | 启动时自动避开坏链路(NCCL 环境变量下传给 Pod) |
| 资源回收 | 推理离线混部时,计算网带宽是共享资源——给推理 job 限带宽(如 K8s NetworkPolicy/QoS),防 NCCL 被抢 |
千卡集群上线 checklist:
- 所有节点 8 NIC 都激活到对应 rail Leaf
-
nvidia-smi topo -m全部 NV2/NVLink 内部直连 - nccl-tests AllReduce 带宽跨机 ≥ 90%理论(400G×8 每节点)
- 单 Leaf 拔线演练:确认只影响 1/8 带宽且 job 不死
- 存储网和计算网隔离验证(
ibstat看不到计算网外的卡) - 监控告警:GPU 掉线/ECC/NCCL timeout/IB link down 都有告警
8. 要记住的数字
- 千卡 = 128节点 × 8卡;每卡 1 个 400G NIC(NDR)→ 计算网 1024 个 400G 端口
- Rail = 按 GPU 槽位分组:第 k 张卡的 NIC 全连到 Leaf-k;8 卡机 → 8 rail
- 计算网 1:1 无收敛,存储网 4:1,管理网万兆;训练 AllReduce 是带宽大户
- 跨机 AllReduce 70B ≈ 280GB/step → 每节点 2.2Tbit/s ≈ 8×400G
- 64 节点 SU:8 台 64口 Leaf + 2 台 Spine;1024卡 ≈ 20 台核心交换机(仅计算网)
- NVLink 900GB/s = 18× 400G;TP 机内、DP 跨机是物理速率决定的
- NVL72 架内 NVLink 130TB/s,TP 域从 8 卡扩到 72 卡;故障域变大是代价
- 排障三件套:
nccl-tests压测、ibdiagnet查光模块/BER、NCCL_DEBUG=INFO看通道