NCCL初探(NCCL_CROSS_NIC与多平面网络)
前面聊了网卡、DMA和RDMA,接下来把视角拉到多机训练。
假设每台服务器上都有两张RDMA网卡,分别接到两个网络平面。网卡单独测都没问题,但放到NCCL里,数据到底会走哪张卡?两个平面能不能同时用?如果平面之间根本不通,又该怎么办?
这时候经常会碰到一个环境变量:NCCL_CROSS_NIC。名字里有个CROSS,很容易把它当成“多网卡开关”。但真按这个思路去配置,可能从第一步就理解偏了。
这篇就围绕这个参数展开,把0、1、2的区别,以及容易想当然的几个地方说清楚。
作者比较关心的不是把参数说明再抄一遍,而是几个具体问题:
- 设成0,是不是就只用一张网卡了?
- 设成1,为什么有人更快,有人反而更慢?
- 两个平面不互通,设成0是不是就万事大吉?
先别急着改参数,从接线开始看。
多平面
假设有A、B两台服务器,每台两张网卡。A的NIC0和B的NIC0接在平面0,两个NIC1接在平面1。
画出来其实很简单:
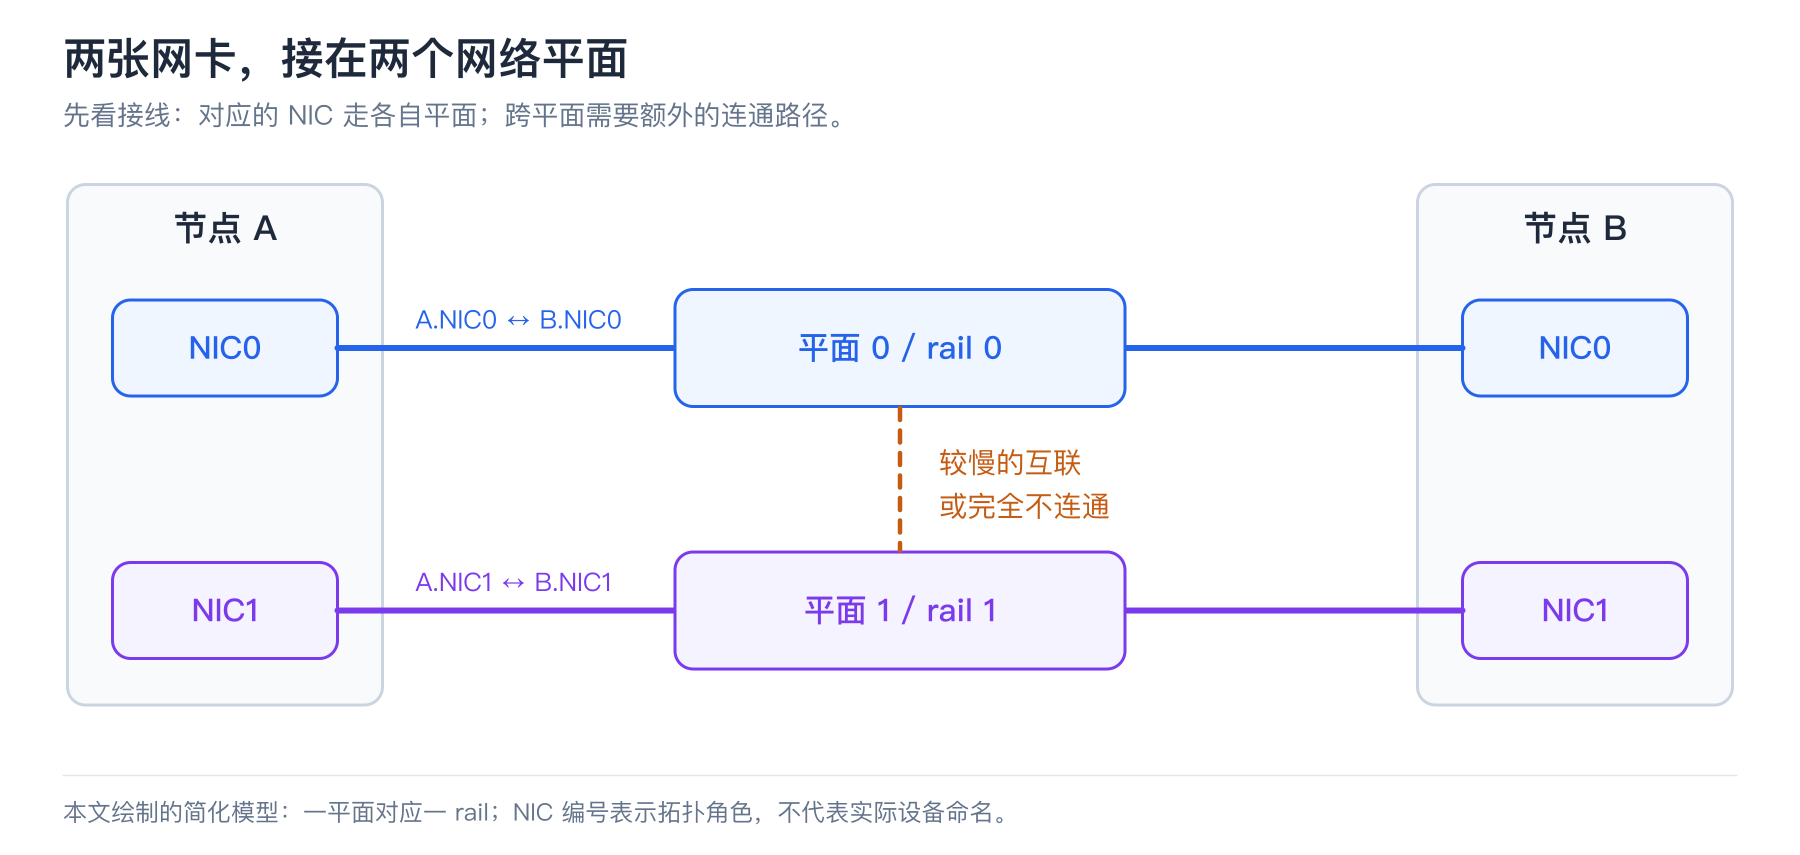
这类接法接近NVIDIA文档里说的rail-optimized。这里先把一条rail理解成图中的一个网络平面即可,复杂硬件里的rail和plane不一定是一一对应关系。
为什么要这样接?
如果数据一直在对应的平面里传输,两路流量就不用都挤到平面间的链路上。NVIDIA的这篇PXN介绍里也解释了这种网络设计。
但这里有一个很重要的前提:平面内部很快,不代表平面之间也很快。
比如,A.NIC0发给B.NIC0,留在平面0就能完成。A.NIC0要发给B.NIC1,则需要平面之间有路可走。如果这条路比较慢,就可能拖后腿;如果压根没连通,那就不只是性能问题了。
反过来,如果所有网卡都接在同一台交换机上,跨NIC没有明显的额外代价,情况又不一样。
所以,看到“多网卡”三个字,还不能决定这个参数该怎么配。先确认网卡接到了哪里。
还有,图中的NIC0只是为了方便说明。不要看到两台机器都叫mlx5_0,就认定它们属于同一个平面,实际布线和设备映射还是要核对。
NCCL_CROSS_NIC
官方文档说,这个参数控制同一个ring/tree是否允许使用不同的NIC。单网卡场景下,它没有作用。
先用ring来理解。ring可以看成数据依次经过各个GPU的一条环形通信路径,这里只截取它在一台服务器里的部分:
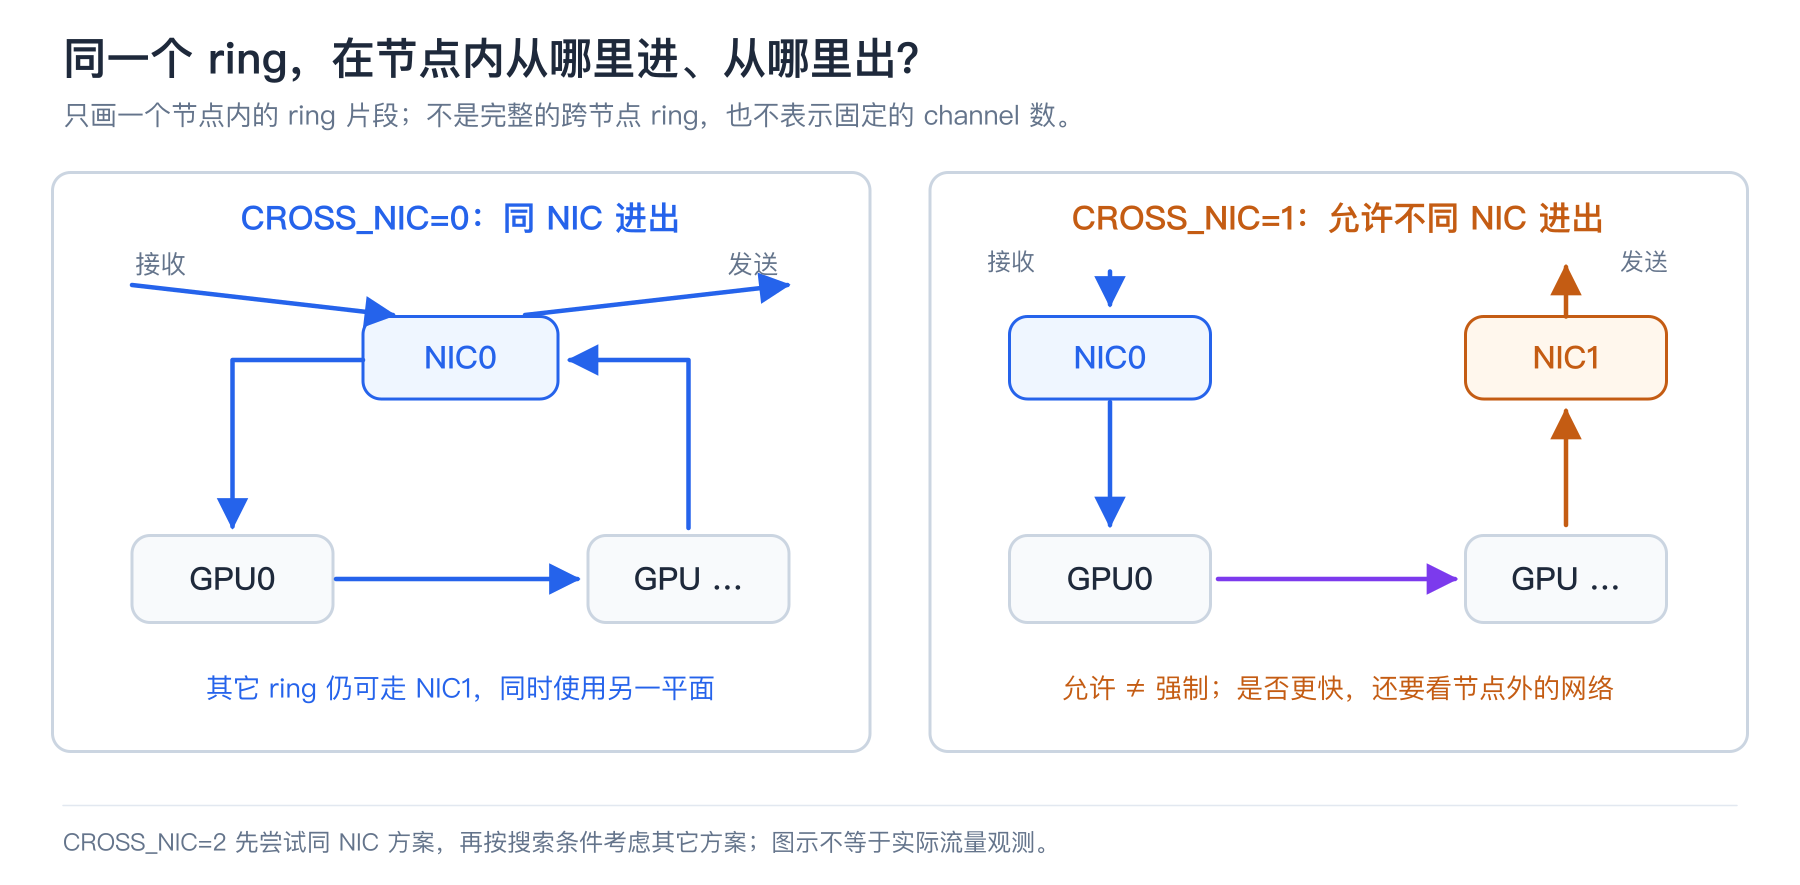
- 0:约束同一个ring使用对应的NIC。
上图左边,数据从NIC0进来,经过节点内的GPU,最后还是从NIC0出去。0对同NIC施加约束,不是像默认值2那样允许为性能放开限制;但能否在整个通信组里保持平面对齐,还有前提,后面会展开。
先回答第一个疑问:这不代表整个任务只用NIC0。
另一个ring完全可以用NIC1,走另一个平面。因此,不跨NIC和不用多网卡是两回事。图里也没有说NCCL一定只建两个ring,或者一定把流量平均分到两张卡上。
- 1:允许一个ring从不同NIC进出。
上图右边,从NIC0进,经过GPU后从NIC1出,也是可以考虑的方案。
好处是什么?有时最后一个GPU离NIC1更近,不必为了回到NIC0而走一条不理想的节点内路径。但节点内省下来的代价,可能又花在了节点外的跨平面链路上。
所以它是允许,不是强制,更不是“开启后带宽自动翻倍”。
- 2:默认值,先尝试同NIC,再按搜索条件考虑其它方案。
可以把它理解成:优先照顾rail对齐,但给性能留一点调整空间。
这里的“性能”来自NCCL的拓扑搜索与评估,不是先把0和1各跑一遍训练,选成绩好的那个,也不是运行过程中发现交换机堵了,就实时切换参数。
回到开头的两种网络:
- 平面间链路比较弱,优先用0做基线,再与2比较,比较容易看清跨平面的代价。
- 各NIC充分互通、跨NIC没有明显额外成本,可以把1也拿来对照,看看放开限制是否有收益。
如果两个平面完全隔离,则要先保证选出来的通信端点可达,不能只想着“哪个值最快”。
看一点源码
源码不展开太多,只看一处就能理解为什么0和2有时表现一样。
在NCCL v2.27.7-1的src/graph/search.cc中,ncclTopoCompute()初始化图搜索状态时有这样一行:
1 | graph->crossNic = crossNic == 1 ? 1 : 0; |
也就是说,只有配置值1直接从允许跨NIC的状态开始,0和2都先从不跨NIC开始。
后面的搜索分支里,配置为2且满足相应条件时,才会对Ring等方案放开限制,再搜索一次。其它带宽、路径和停止条件,这里就不铺开了。
另外,0在候选NIC筛选时会检查设备的asic和port。它依赖的是NCCL识别出来的拓扑,并不是拿着这个参数去检查交换机接线和路由表。
还有一个看日志时容易踩的点:不要看到crossNic非零,就断定已经产生了跨平面流量。这个版本还有交错ring来避免跨rail的处理,最终还是要看两端连接到了哪个设备。
源码先看到这里,记住:参数影响的是路径怎么选,不会替我们把物理网络变成另一种拓扑。
PXN
这里顺带说一下PXN,因为它很容易和CROSS_NIC混在一起。
问题:GPU0想把数据发给另一个节点的GPU1,但两者附近的网卡不在同一个平面,怎么办?
在满足条件时,可以先在主机内部中转:
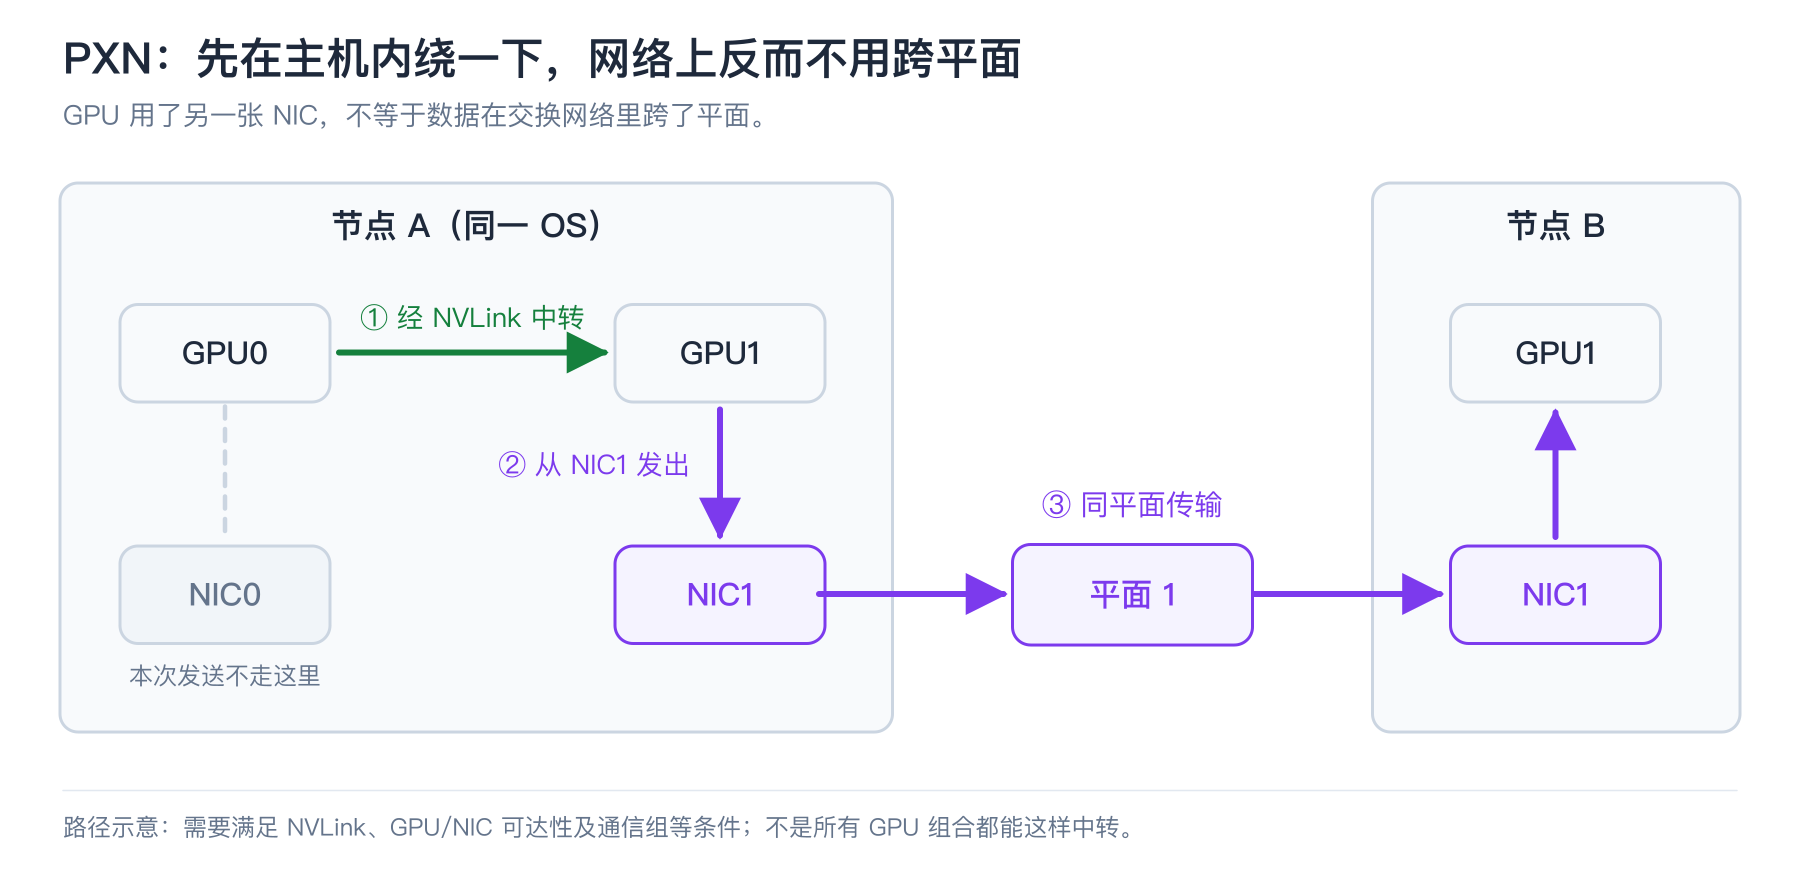
- A.GPU0先通过NVLink,把数据交到A.GPU1。
- 再从A.GPU1附近的NIC1发出。
- 经平面1,到达B.NIC1和B.GPU1。
看起来在节点内部绕了一下,但数据出了服务器以后,反而不用跨平面了。
所以,“GPU用了另一张网卡”和“数据在交换网络里跨了平面”,不是一回事。
NVIDIA项目成员在issue #2193里也解释了两者的关系:在平面不互通时,不同rail所属GPU之间的Send/Recv可能需要PXN才能完成。
不过,能不能中转,还取决于节点内连接和通信组。该讨论也提醒PXN的中转范围限于单个OS,不能理解成任意借用别的主机上的GPU。
因此,测试NCCL_CROSS_NIC=0时,别顺手把PXN也关了。一次改两个变量,最后很难说清楚到底是谁起了作用。
设成0,为什么还可能卡住
前面留了一个问题:0既然约束同NIC,是不是两个隔离平面就可以放心用了?
不一定,还得看哪些GPU被放进了同一个通信组。
比如下面这个简化场景,只把A.GPU0和B.GPU1放到一起,其它GPU不参与,而且假设只能使用图中画出的GPU/NIC路径:
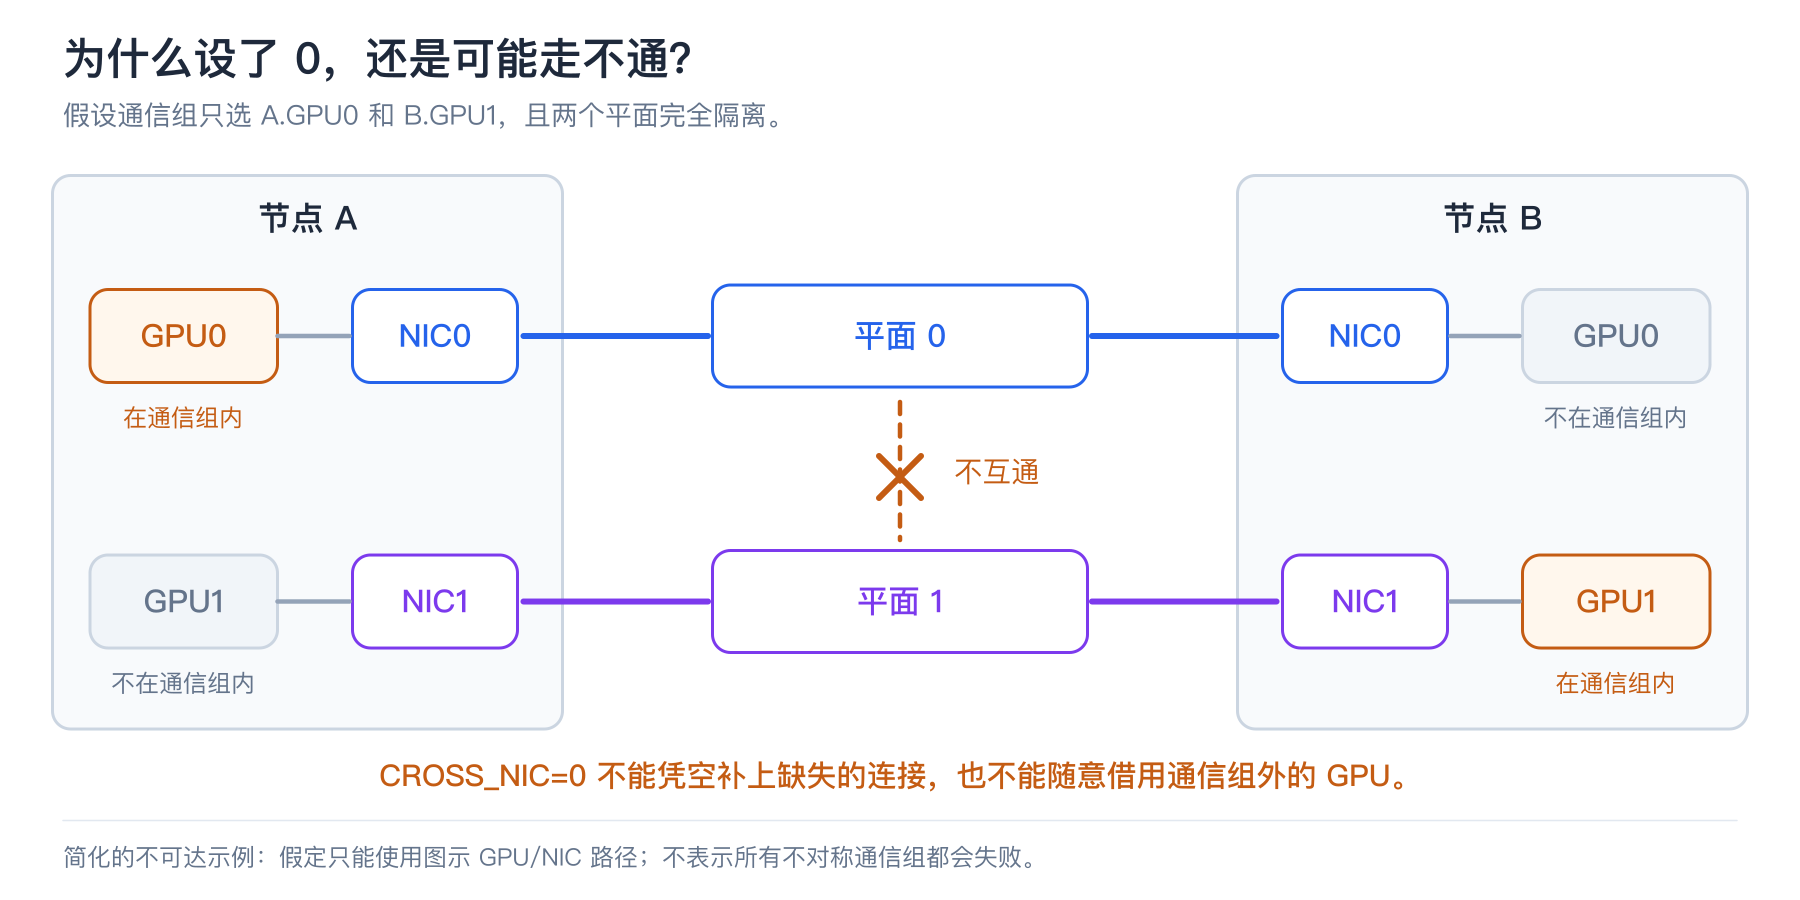
这时候,不能指望NCCL凭空把两个平面连通,也不能随意让通信组以外的GPU来帮忙中转。
这不是故意找一个极端例子。官方文档就注明:不同节点参与通信的GPU不一致时,仍可能需要跨NIC。项目成员的回复也举了跨节点GPU分组没有按rail对齐的例子。
当然,上图不代表所有不对称分组都会失败;如果实际还有其它可用的GPU到NIC路径,需要按实际拓扑分析。
因此,整机8张卡跑通,不等于训练框架切出来的每个小通信组都能照样跑通。排查时不只要问“每台机器几张卡”,还要问:具体是哪几张卡,被分到了哪一组?
公开问题里还有一个很直观的例子:issue #2345。
报告者使用两台服务器,每台4张H200,两个RoCE平面不互通,NCCL版本是2.30.7+cuda13.3。已经设了0,任务还是挂起。
后来查日志,物理上只有两台服务器,NCCL却显示nNodes=4、localRanks=2。2026-09-15,报告者反馈:增加NCCL_NET_DISABLE_INTRA=1后,变成了nNodes=2、localRanks=4,任务不再挂起,但他仍对部分路径的性能有疑问。
这里不是让大家照抄这个参数,而是提醒:我们以为的节点和通信组,未必就是NCCL实际看到的样子。
设成1,到底能快多少
这个问题没法脱离环境回答,但有一组别人的测试很值得看。
issue #1411中,报告者在两台H800节点上测Ring AllReduce。每节点用4张GPU和用满8张GPU,改同一个参数,效果居然反过来了。
把原帖8 GiB消息、out-of-place的busbw画出来:
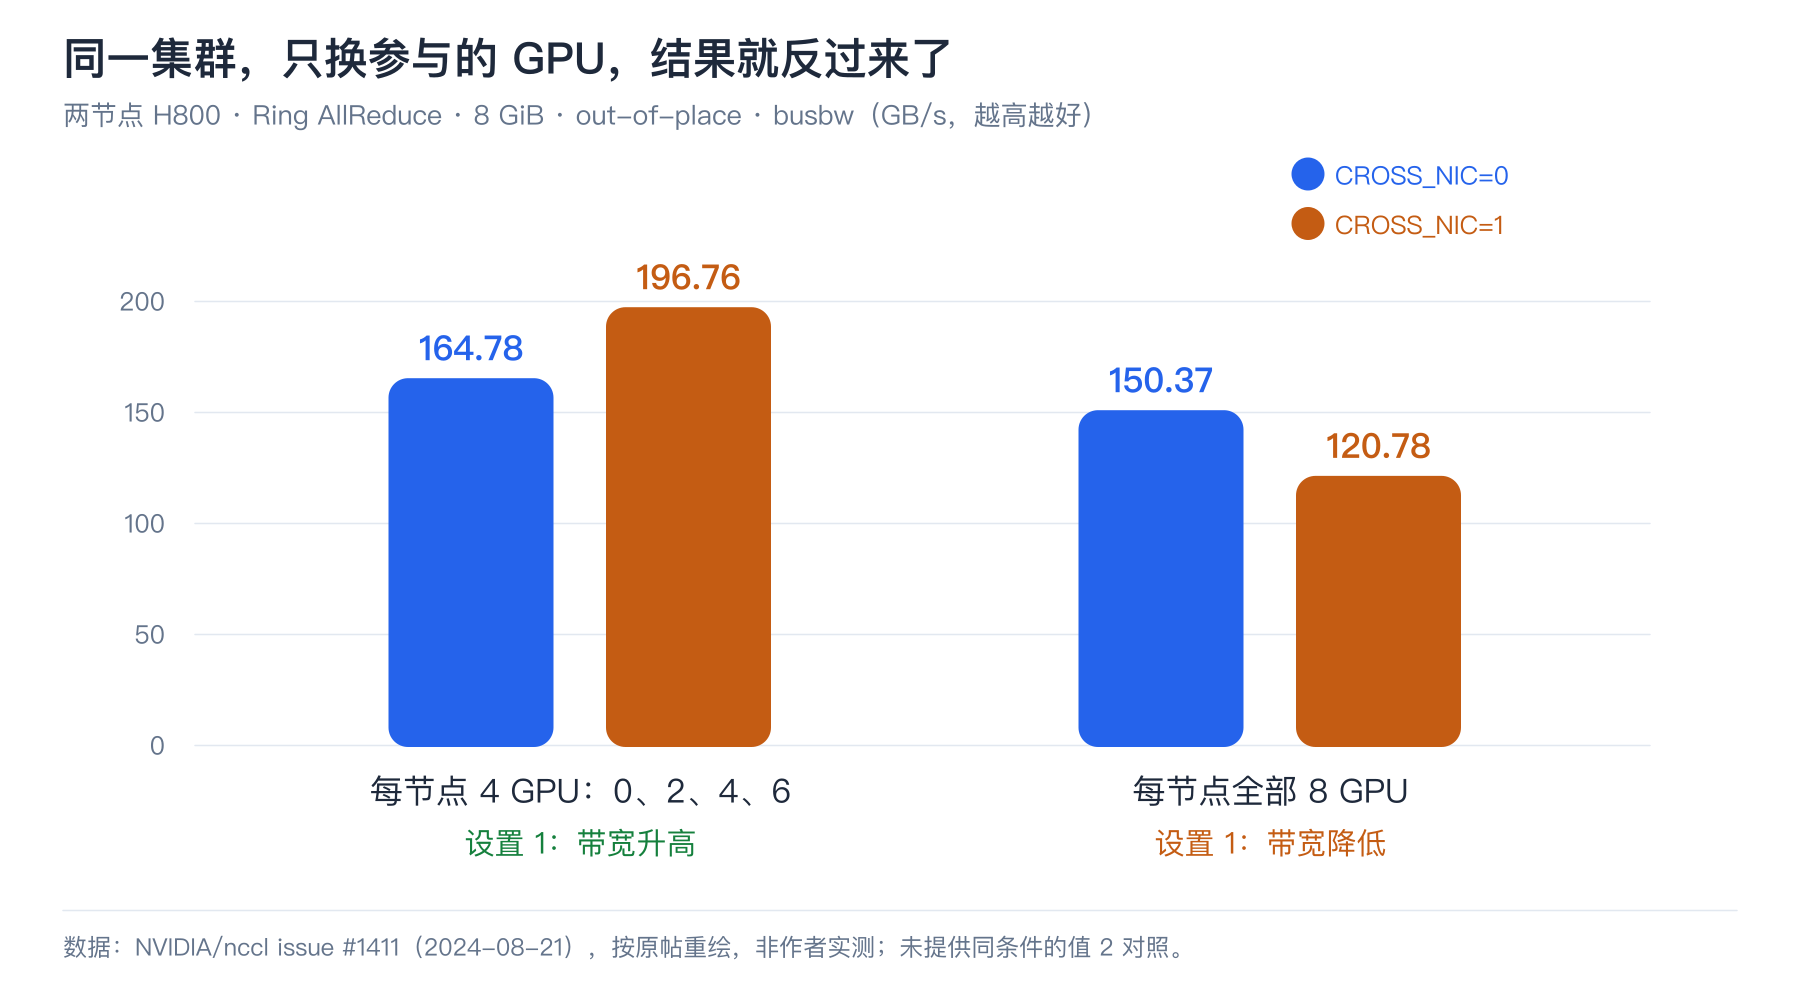
每节点只用0,2,4,6时,设成1,带宽从164.78升到196.76 GB/s。
但用满8张卡后,设成1,反而从150.37降到120.78 GB/s。
光看前一组,很容易写出“打开CROSS_NIC可以提升带宽”的结论;把后一组也放进来,就知道不能这么下结论了。
原帖没有给出维护者确认的完整原因,也没有2的同条件对照。能说明的是:哪几张GPU参与通信,本身就可能改变这个参数的收益。 不能据此说1一定更快,也不能推断默认值2一定会选到最好的结果。
这里再提醒一个单位问题:busbw是nccl-tests按通信操作换算出来的指标,不是拿网卡计数器直接读出来的流量。计算方式可以单独看,不宜拿它直接证明某一条NVLink或NIC“突破了物理带宽”。
版本也别忽略。issue #1494还报告过ring交错后GPU/NIC匹配异常、性能下降和PFC的问题。虽然讨论中提到2.26有相关修复,但报告者后来仍反馈问题未完全解决,不能只读第一条回复就认为全部修好了。
另一个双端口HCA识别问题,报告者最后发现实际测试的是2.29.3,而不是原先以为的2.29.7;后者已有相关修复。排查前先确认进程实际加载的NCCL版本,这一步并不多余。
怎么在自己的环境里试
不要一次复制一大串“调优参数”。先把变量控制住,只改NCCL_CROSS_NIC。
下面以Open MPI、两节点、每节点8张GPU为例。假设nccl-tests已启用MPI编译,程序和动态库在两台机器上的路径一致;在nccl-tests根目录执行,主机名、网卡名按实际情况替换。
1 | # 先从0开始;网络允许时,再分别改成1、2做对照。 |
两个平面完全隔离、可达性还没确认时,不要直接把1和2都跑一遍。 给测试任务设置运行时限,避免一直占着卡等。
命令里也没有主动固定算法,先观察实际选择。如果已有配置里设置了NCCL_ALGO、PXN或其它调优项,要先记录清楚,几组测试保持一致。需要专门看Ring时,再单独固定NCCL_ALGO=Ring并传给所有rank。
除了看最后一行带宽,至少再看这几件事:
- 有没有挂起、网络错误,结果检查
#wrong是不是0。- 两端日志各自选了哪张NIC,对应到哪个物理平面。
- 各网卡流量和平面间链路流量是否符合预期,有没有拥塞或PFC增长。
- 换成训练实际使用的GPU分组后,结果是否还成立。
日志里的%h和%p分别是主机名和进程PID,记得把两台机器上的文件都收回来。只看其中一端,往往只能猜另一端怎么走。
如果启用了NIC合并,还要确认日志里的逻辑设备对应哪些物理端口,别把一个NET编号直接当成一张物理网卡。
最后,不要只测两台整机的一次AllReduce。多跑几次,覆盖实际节点规模、GPU分组和业务用到的其它通信操作,再决定这个参数要不要长期保留。
小结
说了这么多,其实最想说明的是:NCCL_CROSS_NIC不是多网卡开关,而是影响通信路径选择的参数。
- 0,不等于只用一张卡,也不是隔离网络的万能保险。
- 1,允许跨NIC,但不保证更快。
- 2,默认的折中选择,不是自动测速选最优。
先看接线,再看GPU怎么分组,最后看NCCL实际选了什么路径。比起反复试几个数字,这样更容易把问题说清楚。
参考文章:
- https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/env.html#nccl-cross-nic
- https://developer.nvidia.com/blog/doubling-all2all-performance-with-nvidia-collective-communication-library-2-12/
- https://github.com/NVIDIA/nccl/blob/v2.27.7-1/src/graph/search.cc
- https://github.com/NVIDIA/nccl/blob/v2.27.7-1/src/graph/connect.cc
- https://github.com/NVIDIA/nccl/issues/2193
- https://github.com/NVIDIA/nccl/issues/2345
- https://github.com/NVIDIA/nccl/issues/1411
- https://github.com/NVIDIA/nccl/issues/1494
- https://github.com/NVIDIA/nccl/issues/2097
- https://github.com/NVIDIA/nccl-tests
- https://github.com/NVIDIA/nccl-tests/blob/master/doc/PERFORMANCE.md