词汇图鉴⑤ NCCL 通信链路 + RDMA 网络(glossary-05)
对应路线图 Phase 2(W6-W9)的通信部分 + Phase 4(W17 nccl-tests)。
这一份回答三个问题:多卡之间的数据到底怎么传?NCCL 在链路里扮演什么角色?
为什么 NCCL 一挂,整个训练就卡死?读完你应该能看懂:
NCCL_DEBUG=INFO日志、nvidia-smi topo -m拓扑图、
以及为什么 IB(InfiniBand)比普通以太网快一个数量级。
1. 一句话:三条链路的全景
从单卡到跨机,GPU 通信分三个层次,快慢差 3-4 个数量级:
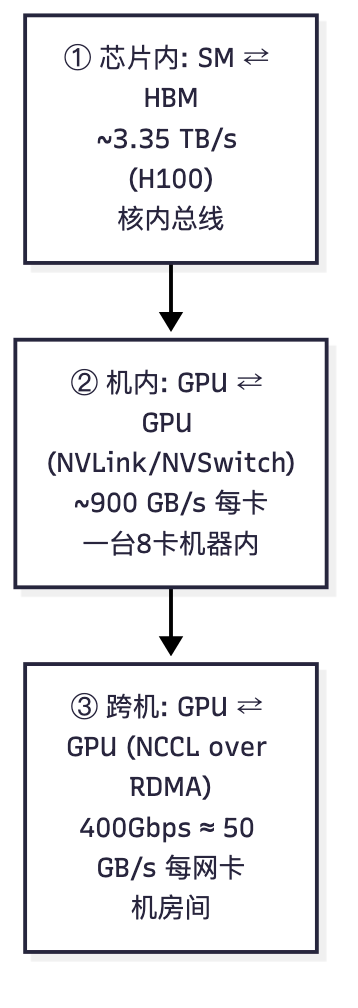
| 层级 | 介质 | 带宽 | 时延 | 谁在用 |
|---|---|---|---|---|
| 芯片内 | 片上总线/共享内存 | 3.35 TB/s (H100) | ~纳秒 | 单卡 kernel 内部 |
| 机内 GPU-GPU | NVLink + NVSwitch | 900 GB/s(每卡单向) | ~微秒 | TP、DP 梯度 AllReduce |
| 跨机 GPU-GPU | RDMA(IB/RoCE)+ NCCL | ~400 Gbps = 50 GB/s | ~1-2μs | DP/PP/EP 跨节点通信 |
系统管理员类比:三级就是 CPU 的 寄存器→L2→内存→SSD 的带宽阶梯翻版——
NVLink 是”机内专线”,RDMA 是”跨机专网”。训练软件的并行度(TP/PP/DP)本质上是一个
“哪些通信走哪级链路”的布局决策。
要记住的数字:
- NVLink 900 GB/s vs RDMA 400Gbps(≈50GB/s):差 18 倍——这就是”TP 只放在机内”的物理原因
- RDMA 时延 1-2μs vs TCP 局域网 50-100μs:差 50-100 倍
- 跨机 AllReduce 的通信量随 GPU 数线性增长 → 你是带宽瓶颈还是算力瓶颈,决定了副本数能开多大
2. RDMA:绕过内核的”直达内存”网络
2.1 为什么普通 TCP 不够快
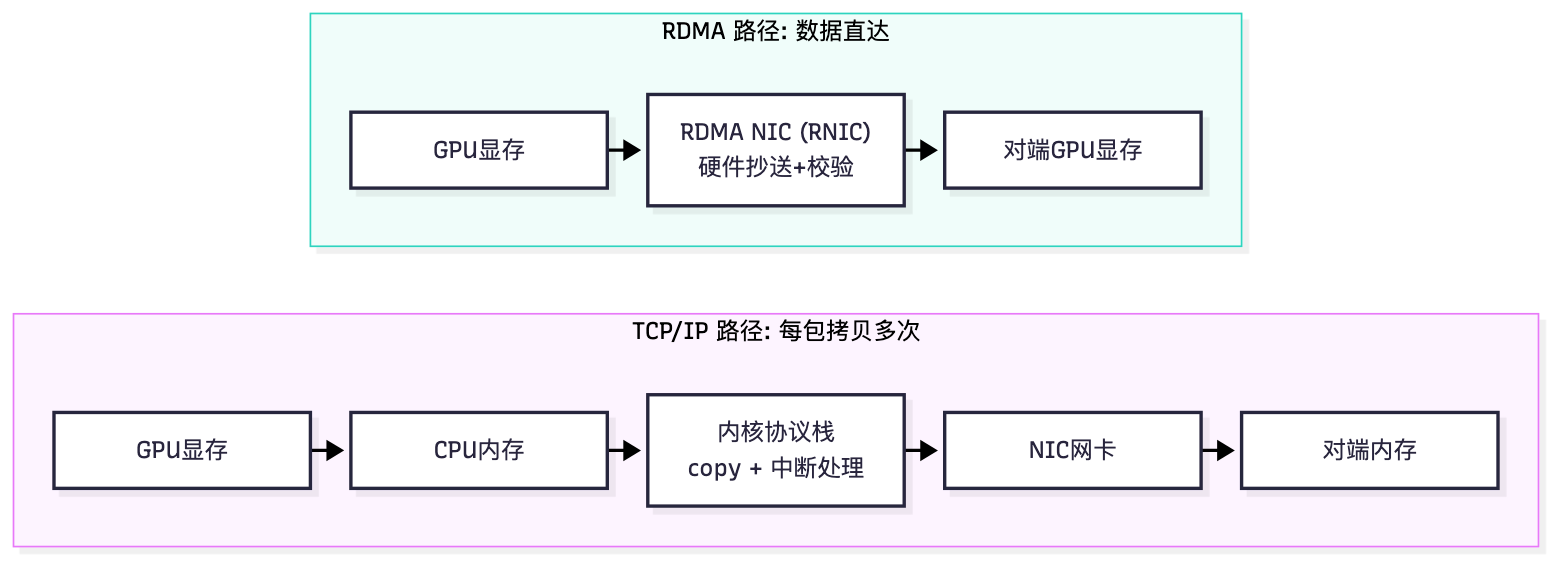
TCP 慢的根源:数据要在 内核态里多次拷贝(用户态→内核态→网卡→对端),每次拷贝都要 CPU 参与 + 中断处理;
RDMA 的关键是 Kernel Bypass:NIC 直接通过 DMA 读写对端及本端内存,CPU 完全不碰数据,
只在启动时设置一次(注册内存、建立队列对)。
一次 RDMA 读的流程(工作量在硬件不在 CPU):
- 发送方把要传的内存区域注册(
ibv_reg_mr),拿到 key - 建立 QP(Queue Pair,类似 TCP 连接)
- 发送 WQE(工作请求):”把这段内存读给对端”
- RNIC 硬件直接 DMA 抄数据到对端指定内存,完成后 CQE 通知
- CPU 全程不接触数据——这就是”零拷贝 + 内核旁路”
系统管理员类比:TCP 是快递员逐件搬(CPU 参与每包),RDMA 是”两台机器的内存地址通了条 DMA 专线”,
用”内存到内存”取代”内存→网卡→内存”。NCCL 的 AllReduce 数据全程不落 CPU 内存——这就是为什么
你 top 看 CPU 很低但网络跑满。
2.2 IB vs RoCE:两条 RDMA 物理实现
| 特性 | InfiniBand (IB) | RoCE(RDMA over Converged Ethernet) |
|---|---|---|
| 本质 | 专用 RDMA 网络(独立协议栈) | 以太网上跑的 RDMA |
| 速度代 | EDR 100G → HDR 200G → NDR 400G → XDR 800G | 与以太网同步:400G/800G |
| 无损保证 | 天生无损(链路层流控) | 需要 PFC 流控 + ECN 标记(无损以太网) |
| 生态 | 需 IB 交换机(NVIDIA/Mellanox) | 通用交换机(Arista/Cisco 等)+ RoCE 网卡 |
| 成本 | 贵(专属硬件) | 便宜(复用以太网) |
| 成熟度 | 超算/大厂训练标配 | 成本敏感场景(部分云厂商) |
| 运维要点 | UFM 管理、SM 配置、AR 自适应路由 | PFC 死锁、ECN 阈值调优是坑 |
管理员关键知识点:
- 无损网络是前提:RDMA 丢一个包重传代价极高 → 以太网要开 PFC(Priority Flow Control 暂停帧)保证不丢。
PFC 配置不当(阈值错误)可导致整网死锁/吞吐悬崖——这是 RoCE 集群最著名的排障点 - GID/Queue Pair:RDMA 寻址用 GID(IPv6 形式地址);每个 QP 一对队列。
ibv_devinfo可查 - SM/AR:IB 需要子网管理器(SM);自适应路由(AR)让不同报文走不同路径减少拥塞
要记住的数字:
- NDR 400Gbps ≈ 50 GB/s 单方向;双向 100 GB/s
- IB 时延 ~0.5-1μs(端口间);RoCE 略高
- 一台 8 卡机通常配 8 个 400G 网卡(每 GPU 一张)做跨机——8×50GB/s = 400GB/s 跨机总带宽,
仍远低于机内 NVLink 900GB/s×8——所以跨机大模型并行必须”通信最少化”(PP/ZeRO 多、TP 少)
3. NCCL:多卡集合通信的”运行时”
3.1 NCCL 是什么
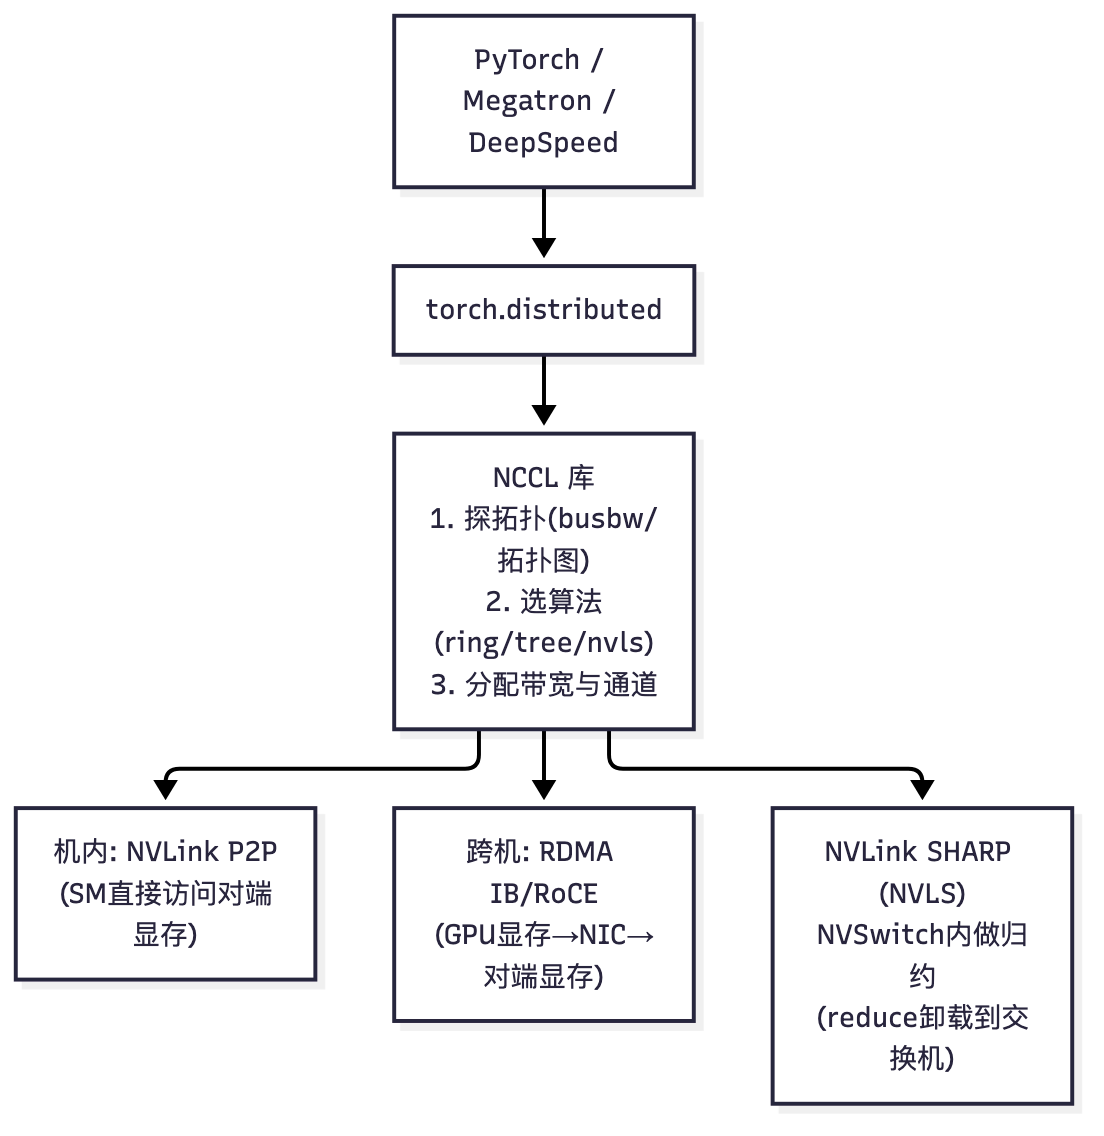
NCCL(NVIDIA Collective Communications Library) 是 GPU 上的集合通信库:
给 PyTorch/DeepSpeed/Megatron 提供 AllReduce / AllGather / ReduceScatter / AlltoAll 等原语,
内部自动选择最佳链路(NVLink or RDMA 或混合)和拓扑算法。
你看到的封装:torch.distributed.all_reduce() → 后端(nccl)→ NCCL 内部创建通信组、选算法、派发 kernel。
3.2 NCCL 的三种通信算法
| 算法 | 原理 | 用在哪 | 特点 |
|---|---|---|---|
| Ring(默认) | 张量切 N 块沿环搬运+局部归约;带宽利用 ≈ 2(N-1)/N | 通用 | 简单稳定、带宽高效,但任意一环慢→全链接慢 |
| Tree | 树形分层归约(叶子算完向上合并) | 大消息 / 跨机延迟敏感 | 减少链路跳数;对坏链路不如 ring 敏感 |
| NVLS(NVLink SHARP) | NVSwitch 硬件内做归约(in-network reduction) | 机内 8 卡全互联 | 归约在交换机上完成:带宽更高、CPU/SM 不参与;H100 起支持 |
一句话理解 NVLS:以前 AllReduce 是”数据先搬进 SM 算完再搬出”;NVLS 让 NVSwitch(交换机芯片)直接在路上做求和,
GPU 只要发出数据、收最终结果——类似 数据面智能卸载(交换机内计算),你排障时看 NCCL 日志里的 nvls 通道就懂了。
3.3 主机内各 rank 的 PCIe 拓扑(为什么拓扑决定速度)
nvidia-smi topo -m 输出里能看到 GPU 之间是 NV2(NVLink 直连)、NV1/NV4(级联)、还是 PIX/PXB/SYS(PCIe/跨节点):
1 | GPU0 GPU1 GPU2 GPU3 GPU4 GPU5 GPU6 GPU7 |
- NV2 = NVLink 直连(900GB/s)→ 适合 TP
- PXB/PIX = 经 PCIe Switch(~50GB/s)→ 慢一个数量级,适合 DP(要的就少)
- SYS = 跨节点(RDMA 对等通信)→ 最慢
- DDP 若把 TP 组跨机放 → 通信慢了 18 倍,训练被吞掉——这就是为什么
rank分配必须拓扑感知
3.4 关键 NCCL 环境变量(排障手册)
| 环境变量 | 作用 | 你什么时候用 |
|---|---|---|
NCCL_DEBUG=INFO |
打印通信组建立、选路、通道分配 | 每次多卡训练出问题第一步 |
NCCL_DEBUG_SUBSYS=ALL |
更细(拓扑/通信/网络/图) | 深挖时 |
NCCL_IB_DISABLE=1 |
关掉 IB 用 TCP(慢但能救急) | IB 故障时保任务跑 |
NCCL_SOCKET_IFNAME=eth0 |
指定控制平面网口 | 多网卡选错时(最常见坑) |
NCCL_IB_HCA=mlx5_0,mlx5_1 |
指定用哪个 RDMA 网卡 | 多 HCA 选错时 |
NCCL_IB_GID_INDEX |
RoCE 选 GID | RoCE 跨网段不通时 |
NCCL_P2P_LEVEL=NVL |
限制 P2P 最高级别(NVL/PIX/PXB/SYS) | 拓扑认错导致崩溃时 |
NCCL_NET_GDR_LEVEL |
GPU-Direct RDMA 级别(GDR) | 检查 GDR 是否生效 |
NCCL_IB_TIMEOUT / NCCL_IB_RETRY_CNT |
无损网络超时/重试 | RoCE 抖动排障 |
NCCL_ALGO=RING(或NVLS) |
强制算法 | 对比性能 / 绕过坏链路 |
管理员最常踩的三个坑:
NCCL_SOCKET_IFNAME选错了网口(默认 eth0 可能是管理网)→ 训练时快时慢、偶发 timeout- IB 掉线但没设
NCCL_IB_DISABLE→ 反复 retry 卡死 → 先用 disable 保命,再修网络 NCCL_DEBUG=INFO里出现ncclInternalError/ 超时 → 看最后几行往往是环路里的某张卡不可达
4. GPU Direct RDMA (GDR):跨机通信的终极形态
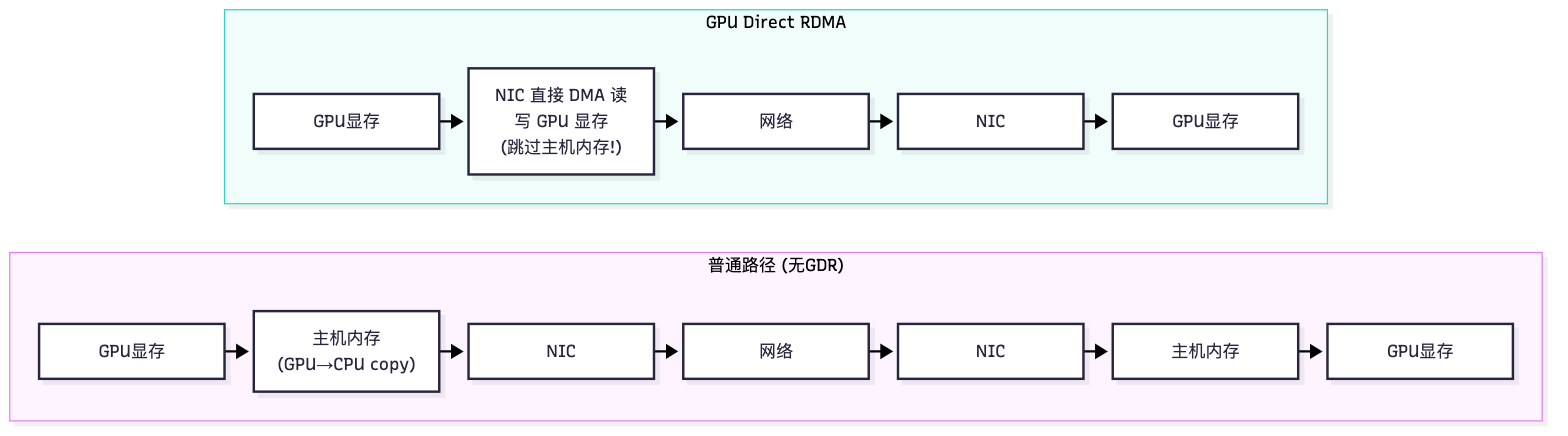
GPU Direct RDMA:NIC 允许直接访问 GPU 显存(通过 NVLink/P2P 映射),
跨机数据从”GPU显存→Host→NIC”变”GPU显存→NIC”——
省掉 2 次主机内存拷贝和对应的 PCIe 往返,时延和带宽都显著改善。
- 前提:NIC 插在 GPU 对等 PCIe 域、驱动开启
NVReg(nvidia_peermem)模块 - 检查:
nvidia-smi里能看到 GPU↔NIC 的 P2P 连接;NCCL_DEBUG=INFO日志显示net#0带 GDR - 没开 GDR 的常见现象:跨机带宽只有一半、
nvidia-smi topo -m无 NVLink 但通信慢
管理员检查命令:
1 | # 拓扑与 NVLink |
5. NCCL 常见故障与排查思路(管理员速查)
| 症状 | 可能根因 | 排查路径 |
|---|---|---|
| 训练卡住无超时 | NCCL 初始化失败,rank 等对端 | NCCL_DEBUG=INFO 看第几个 rank 卡住;查网络连通 |
ncclSystemError: cudaErrorDeviceUnavailable |
某卡被占/掉卡 | nvidia-smi 对比启动时编号 |
ncclInternalError: invalid usage |
rank 参数不一致(world_size 对不上) | 核对启动命令 world/rank/env |
偶发超时 ncclSystemError: timeout |
网卡/链路抖动 | ibstat 查 Rate;换网线/换口;调 NCCL_IB_TIMEOUT |
| 吞吐只有三分之一 | 多轨没用上/选错网口/没 GDR | NCCL_DEBUG=INFO 看 net 通道数;ibv_devinfo 查端口激活 |
| 八卡机内部也慢 | NVLink 拓扑没生效(如虚拟化环境) | nvidia-smi topo -m 看是否 NV2;K8s 里确认不是 MIG/虚拟设备 |
| 同一机柜快、跨机柜慢 | 多轨(rail)布局没按节点连对叶交换机 | 核对 rail 布线;让调度器保持节点内 8 卡同机(见 cluster 文档) |
最推荐的通用策略:NCCL_DEBUG=INFO 是第一工具;日志读倒数 10 行(错误往往在最后);
保命手段 NCCL_IB_DISABLE=1 先把训练救起来,再慢慢修网络。
记忆锚点:三级链路 芯片内→NVLink→RDMA,分别管”算得快、机内传得快、跨机传得快”;
NCCL 是选路由的那层,全自动但需要环境变量伺候;RDMA 的本质是”绕过内核直达显存”;
GDR 让网卡直接读写 GPU 显存。排障口诀:先 DEBUG=INFO,看倒数 10 行,再查 IB 状态。