词汇图鉴④ GPU 底层架构与性能(glossary-04)
对应路线图 Phase 4(W16-18)。这份是”硬件层”词鉴:
之前三份讲模型在算什么、训练怎么并行、推理怎么服务——这一份讲这些计算到底跑在什么硬件上,
以及为什么某些数字(算力/TFLOPS、带宽/TB/s)会卡住你的训练和推理。读完你应该能回答:CUDA Core 和 Tensor Core 的区别、为什么 H100 比 A100 快那么多、
为什么 decode 受带宽限制、nvidia-smi 里每个数字在说什么。
1. GPU 是什么:一句话
GPU 是一个为”海量同构小任务并行”而设计的芯片——几千个简单计算单元同时执行,
配上一块超高带宽的显存。CPU 是几个超强核(few fast cores),GPU 是几千个简单核(many simple cores)。
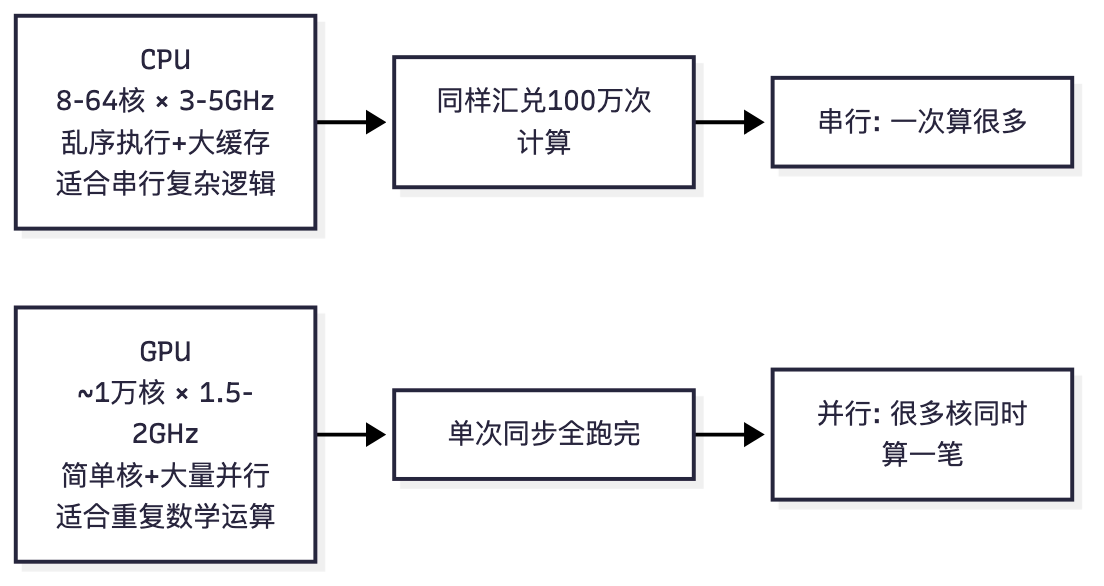
系统管理员类比:CPU 是一个双核高主频的”通用计算服务”,每个请求都极其复杂、依赖重;
GPU 是一万台”只干固定数学运算”的无状态 Worker,任务是同样的运算但数据不同——调度器(CUDA runtime)
把任务切成 warb 分发给所有 Worker。你管理训练集群时看到的”GPU 利用率”,
本质是这批 Worker 有多少在干活。
要记住的数字:
- CPU→GPU 延迟差 ~100×(微秒 vs 毫秒级启动),但吞吐差几千倍
- 一次 GPU kernel 启动(launch)约 3-10 微秒——你觉得”不算什么”,但 1000 次小 kernel 就是 10 毫秒
- GPU 用 HBM 高带宽内存,H100 带宽 3.35 TB/s ≈ CPU DDR5(~50GB/s)的 67 倍
2. 芯片内部结构:SM 是”计算单元组”
GPU 由若干 GPC(Graphics Processing Cluster) 组成,每个 GPC 含若干 SM(Streaming Multiprocessor,流式多处理器)。
SM 才是真正的计算单元——每个 SM 里有 CUDA Core、Tensor Core、共享内存、寄存器堆。
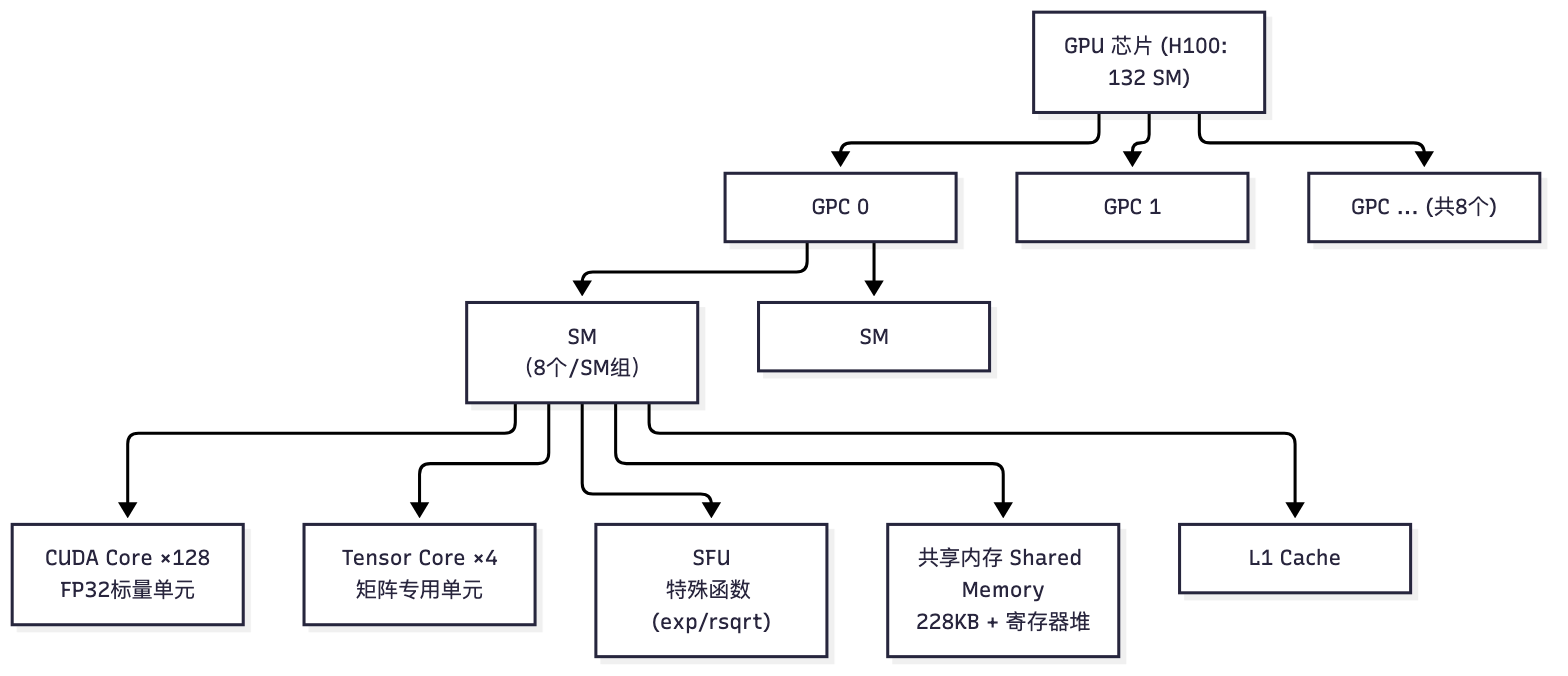
每个部分干什么(类比电信机房):
| 部件 | 干什么 | 类比 |
|---|---|---|
| SM | 计算单元组,管一个”班组”的线程 | 一个机柜 |
| CUDA Core | 单个标量运算(加/乘/比较),一次一个数 | 普通服务器 |
| Tensor Core | 一次算一块矩阵(如 4×4×4),吞吐是 CUDA Core 的 ~10-30 倍 | 专用算力硬件(如 FPGA/ASIC 卸载卡) |
| SFU | exp/sin/rsqrt 等超越函数(softmax/归一化要用) | 硬件加速器(如加密卡) |
| 共享内存 | SM 内所有线程共享的”手工管理高速缓存”,带宽极高 | 机柜内共享内存盘 |
| 寄存器堆 | 每个线程私有寄存器,最快 | 每个进程的寄存器 |
要记住的数字(H100 SXM 为例):
- 132 SM × 128 FP32 CUDA Core = 16,896 CUDA Core
- 132 SM × 4 Tensor Core = 528 Tensor Core
- 每 SM 最多驻留 2048 线程(64 warp),寄存器堆 64K×32bit
- 共享内存 228KB/SM,带宽 ~19 TB/s 级别(远高于 HBM 的 3.35 TB/s)
3. CUDA Core vs Tensor Core:核心对比
CUDA Core
- 一次执行一个浮点运算(如 flt=a*b+c),SIMT(单指令多线程)模式工作
- 32 个线程组成一个 warp(束),一个 warp 同时执行同一条指令
- 对应上一条 glossary 里的”标量乘法”——Transformer 里逐元素运算(激活函数、归一化、缩放)都跑在这
Tensor Core
- 一次执行一块矩阵乘法(如 4×4×4 或 m16n8k16 分块),每个时钟周期完成一个分块 MAC
- 对”精度有要求的混合精度”(FP16/BF16 输入 → FP32 累加)管线化执行
- 大矩阵乘(Linear、Attention 的 QK^T/PV)几乎全部由它完成——Transformer 的 ~90% FLOPs 由 Tensor Core 贡献
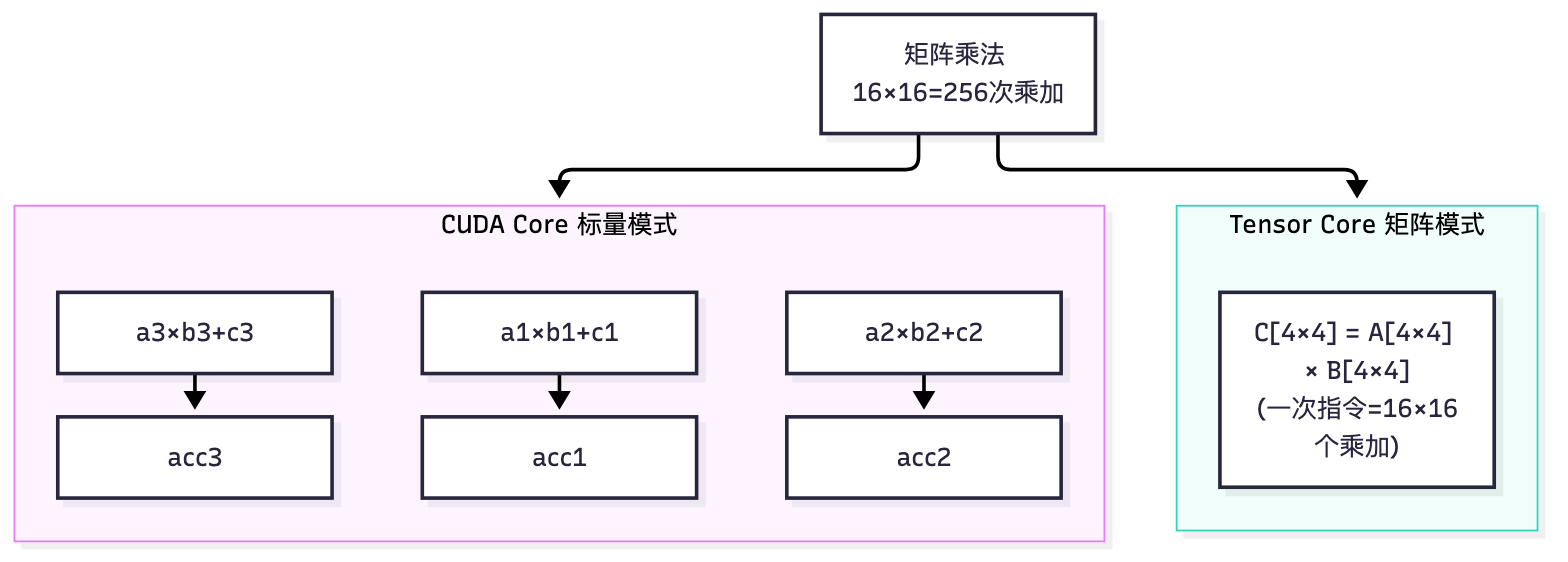
为什么 Tensor Core 快这么多:普通 FP32 流水线做乘加需要读 3 个数,吞吐只有 MUL+ADD 两条指令周而复始;
Tensor Core 在硬件上把分块乘加做成了流水线专用电路,让 16×16 的乘加在一个时钟内完成,
并且通过共享内存直连数据,不经过寄存器/缓存抖动。
系统管理员类比:CUDA Core ≈ 通用服务器逐个跑任务;Tensor Core ≈ 专用的批量转发设备(像专线带宽 vs 普通交换机),
同样 1 秒,它因”专用电路+数据就地处理”吞吐高一个数量级。
要记住的数字(H100):
- FP32 CUDA Core:67 TFLOPS
- FP16/BF16 Tensor Core(dense):989 TFLOPS(约 15 倍)
- FP8 Tensor Core:1,979 TFLOPS(约 30 倍)
- A100 的 FP16 TC 只有 312 TFLOPS——H100 的 TC 是 A100 的 ~3.2 倍
4. 精度与数据类型:数字怎么存的
矩阵运算的精度决定 Tensor Core 的吞吐。核心概念:指数位(决定范围) vs 尾数位(决定精度)。
| 类型 | 位宽 | 指数位 | 尾数位 | 用途 | Tensor Core 吞吐(H100) |
|---|---|---|---|---|---|
| FP64 | 64 | 11 | 52 | 科学计算(高精度) | 34 TFLOPS |
| FP32 | 32 | 8 | 23 | 通用/默认 | 67 TFLOPS |
| TF32 | 32(尾数截断到10) | 8 | 10 | Ampere 起的 FP32 加速替代 | 495 TFLOPS* |
| FP16 | 16 | 5 | 10 | 混合精度训练主力 | 989 TFLOPS |
| BF16 | 16 | 8 | 7 | 大模型训练主力(同 FP32 指数范围) | 989 TFLOPS |
| FP8(E4M3/E5M2) | 8 | 4/5 | 3/2 | Hopper 起训练/推理加速 | 1,979 TFLOPS |
| INT8 | 8 | - | 8 | 推理量化 | 1,979 TOPS |
*TF32 是 Ampere 引入:FP32 输入截断尾数在 Tensor Core 上算,精度比 FP16 高、速度接近 FP16。
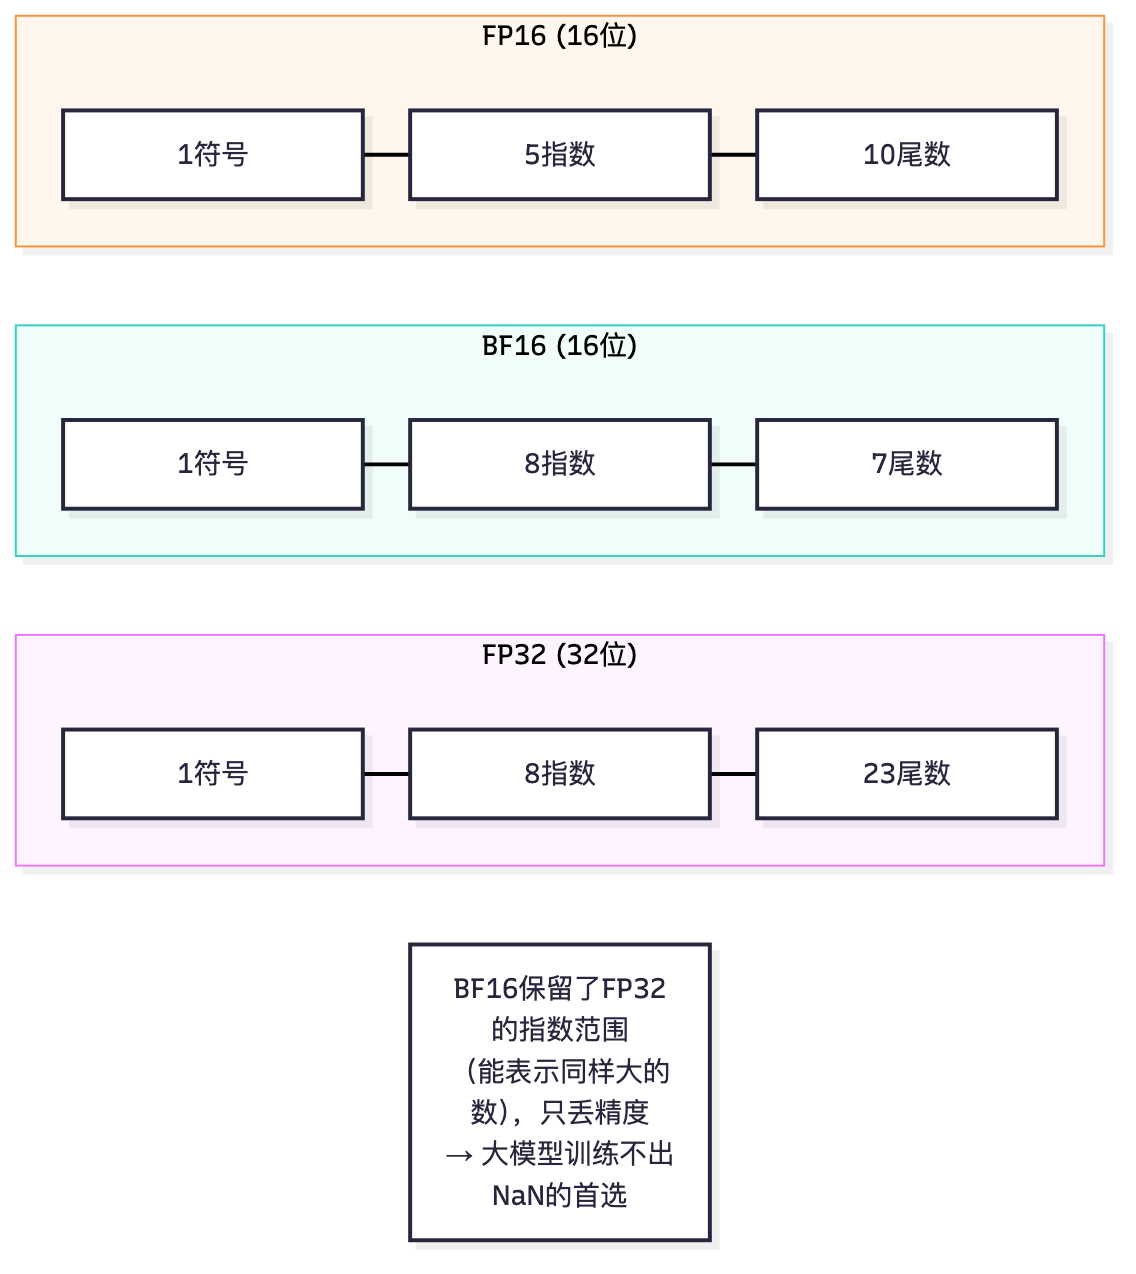
为什么 BF16 在大模型里流行:FP16 指数只有 5 位,训练时 loss 范围波动大容易溢出(变成 inf/NaN);
BF16 指数 8 位与 FP32 相同,范围一样、只降低精度(尾数 7 位)——对梯度更新足够,且数值稳定。
这就是为什么 Llama/DeepSeek 训练全用 BF16 混合精度。
系统管理员类比:精度 = 记账的位数。FP32 记到小数点后 23 位,FP16 记到 10 位但金额范围只有几千(易溢出爆表),
BF16 范围跟 FP32 一样但每笔只记 7 位小数。大规模训练(金额波动极大)选 BF16 更稳。
要记住的数字:
- 混合精度(AMP)标准打法:权重 FP32 备份 + 前向/反向 BF16/FP16 + 梯度 FP32 累加(见 glossary-01 的 16B/参数)
- FP8 是 Hopper 起的”下一代混合精度”,训练提速可达 1.3-1.5×,推理量化后权重占内存再减半
- 精度从 FP16→FP8,Tensor Core 吞吐翻倍(989→1979)
5. 内存层次:为什么带宽决定推理速度
GPU 内存金字塔,从快到慢(也是每次学习必背的那张):
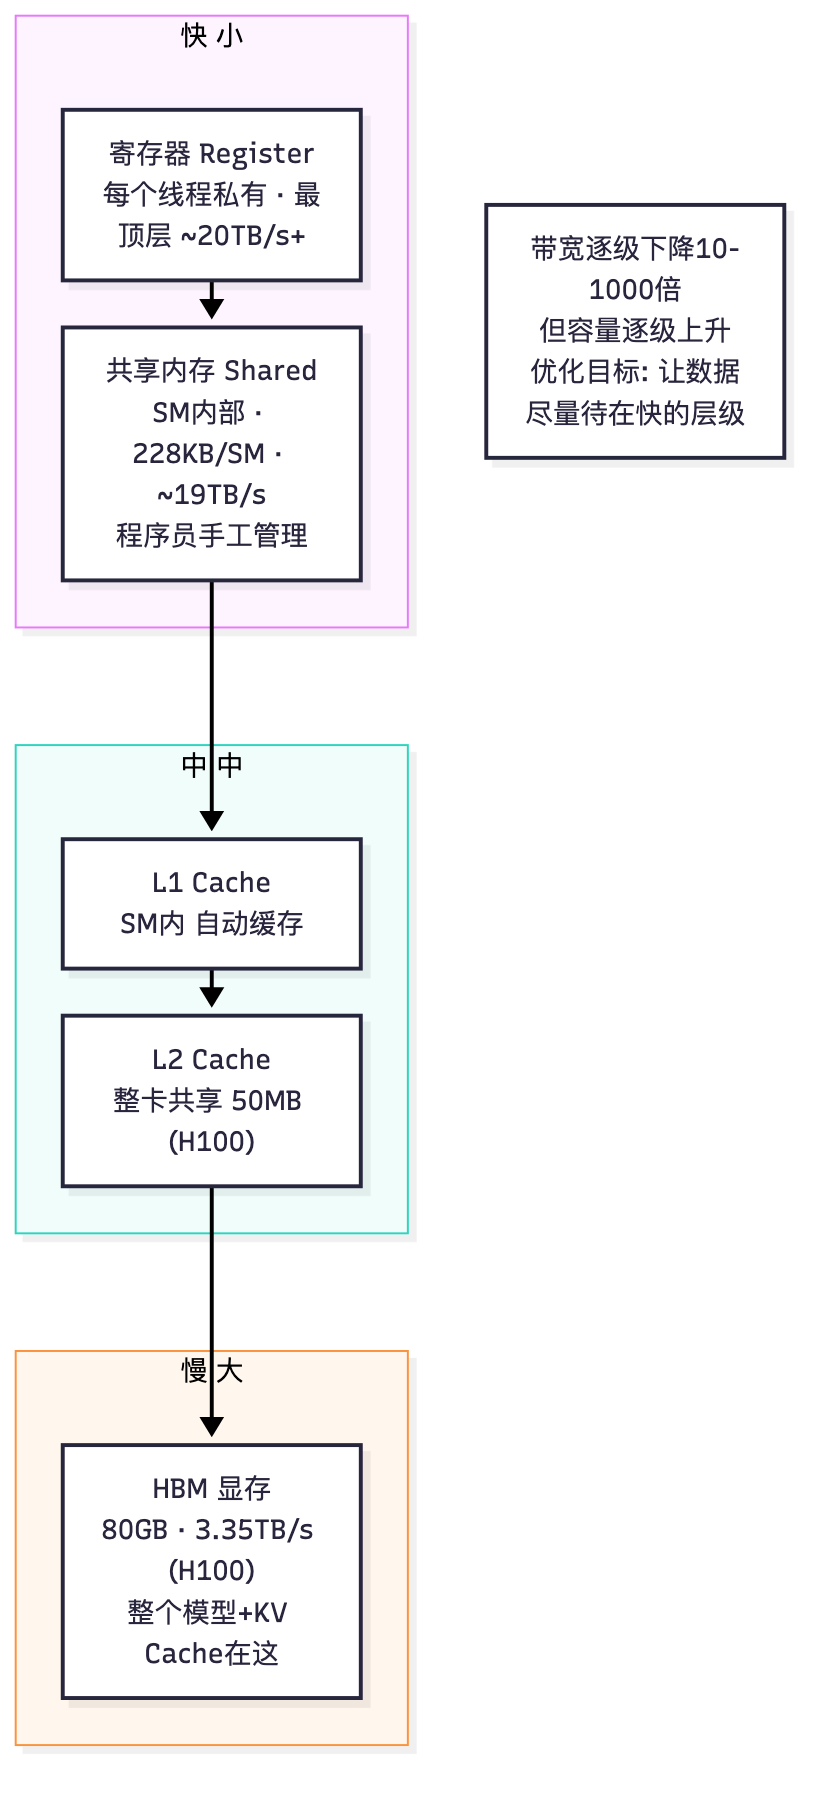
为什么 decode 是 memory-bound(呼应 glossary-03):decode 每生成 1 个 token,需把全部权重
(7B BF16 ≈ 14GB)从 HBM 读到计算单元做矩阵乘。HBM 带宽 3.35TB/s → 每 token 至少 14GB/3.35TB/s ≈ 4.2μs。
这个时间被带宽锁死,加再多 Tensor Core 也无济于事(它们闲着等数据)。
为什么 FlashAttention 快:把 attention 计算切成小块,让”读取→计算→丢弃”完全在共享内存/寄存器里完成,
不把中间矩阵(N×N)写回 HBM——省掉的是慢层级的读写,不是计算量。
系统管理员类比:HBM = 冷数据盘(量大慢),L2 = 热缓存,共享内存 = 每台机器的内存条(快但小),
寄存器 = CPU 寄存器。推理的”每 token 读全量权重” = 每次请求都要全表扫描冷盘——
这就是为什么 decode 快不了:不是算不动,是读不完。
要记住的数字:
- H100:HBM 3.35 TB/s、50MB L2、228KB/SM 共享内存
- A100:HBM 2.0 TB/s、40MB L2
- B200:HBM 8 TB/s、192GB HBM3e
- 共享内存带宽 ~19TB/s vs HBM 3.35TB/s:约 6 倍差距,算得动但搬不动是常态
- MFU 上不去的第一嫌疑:HBM 带宽不够喂 tensor core(roofline 模型,见下)
6. GPU 代际演进:V100 → A100 → H100 → B200
从 Volta(2017)到 Blackwell(2024),每代的关键跳跃:
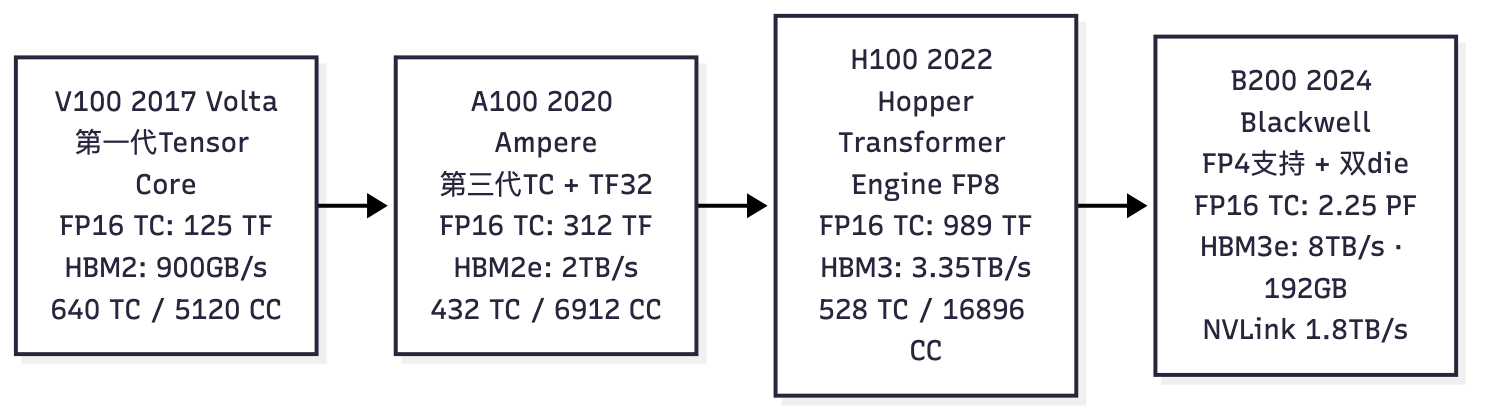
核心变化解读(不看热闹看门道):
- Tensor Core 一代比一代狠:V100→A100→H100→B200 的 TC 能力约 125→312→989→2250 TFLOPS(每代~2-3×)
- 每代引入一种”新精度”作为卖点:V100 引入 FP16 混合精度 → A100 加 TF32 → H100 加 FP8 → B200 加 FP4。
本质都是”精度降一点、速度翻倍”,配合对应的精调/量化技术食用 - 带宽增速慢于算力:H100 算力是 A100 的 3.2 倍,但带宽只涨 1.7 倍——越新的卡,越容易出现”算得动搬不动”
- 单卡显存:A100 40/80GB → H100 80GB → H200 141GB → B200 192GB——大模型推理显存容量焦虑在缓解,
但单卡装不下的模型还是要靠并行(Phase 2 的知识正好接上)
要记住的数字(上表,说得出每代的 TC TFLOPS 和带宽即可)。
7. 稀疏性与其它重要概念
7.1 结构化稀疏(2:4 Sparsity)
- NVIDIA 支持 2:4 模式:每 4 个权重里至多 2 个非零,Tensor Core 可以跳过零值,吞吐翻倍
- H100 的 FP16 sparse = 1,979 TFLOPS(dense 的 2 倍)
- 训练后剪枝到 2:4 通常有精度损失 1-2%,需要重训/校准——生产用得少,了解即可
7.2 Warp 与发散(Divergence)
- warp = 32 线程一组,同一时刻执行同一条指令(SIMT)
- 若 if/else 让 warp 内线程走不同分支 → 串行执行两个分支(浪费一半算力)
- 训练框架(PyTorch)基本不踩这个坑;手写 CUDA/Triton 内核时要注意
7.3 共享内存 Bank Conflict
- 共享内存分 32 个 bank,同 bank 不同地址同时访问 → 冲突串行化
- 重要度:了解即可,排障时极少遇到(框架层已优化)
7.4 CUDA Graphs(图捕获)
- 把一串 kernel launch”录制”成一张图,之后整体回放,省掉几千次 launch 的开销(几 ms → 几十 μs)
- PyTorch
torch.cuda.graph用在小 batch 推理/大批次固定形状时收益明显 - 管理员视角:训练/推理吞吐低且 GPU 利用率跳动的,查是不是 launch 太多、没用 CUDA Graphs
7.5 Kernel Fusion(内核融合)
- 把多个逐元素 kernel(加 bias → 加激活 → dropout)合成一个,减少 HBM 往返
- PyTorch 的
torch.compile/inductor 做这件事;vLLM 深度手写 fused kernel - 优化原理与 FlashAttention 相同:少搬数据
7.6 Triton(OpenAI 开源 DSL)
- 用 Python 写 CUDA 内核,编译器(Triton → PTX)自动做 tile 化、寄存器分配、共享内存调度
- 避免了手写 CUDA 的 90% 样板代码;性能接近手写(多数场景 80-100%)
- 也绕开 CUDA 生态锁定的一个常见选择(AMD ROCm 也支持 Triton)
- 路线图用途:W16 实验用它写内核理解性能模型
7.7 统一内存 / Pinned Memory
- 统一内存:CPU/GPU 共享地址空间,page fault 按需迁移(方便但慢,训练不用)
- Pinned Memory:锁页内存,CPU↔GPU 拷贝通过它走 DMA,是 DataLoader 加速的常见手段(
pin_memory=True)
7.8 Roofline 模型(性能天花板怎么算)
- 一张图判断瓶颈:算术强度 = FLOPs/字节,与机器的峰值算力/带宽比比较
- 算术强度 > 机器甜点 → compute-bound(吃满 TFLOPS);反之 → memory-bound(受带宽限制)
- decode 的算术强度极低(算一点点读一大堆)→ 永远 memory-bound;大矩阵乘(prefill)算术强度高 → compute-bound
8. 管理员视角:nvidia-smi 每个数字在说什么 + 常见故障
对应你日常排障,这里给一张”字段解读 + 排查树”:
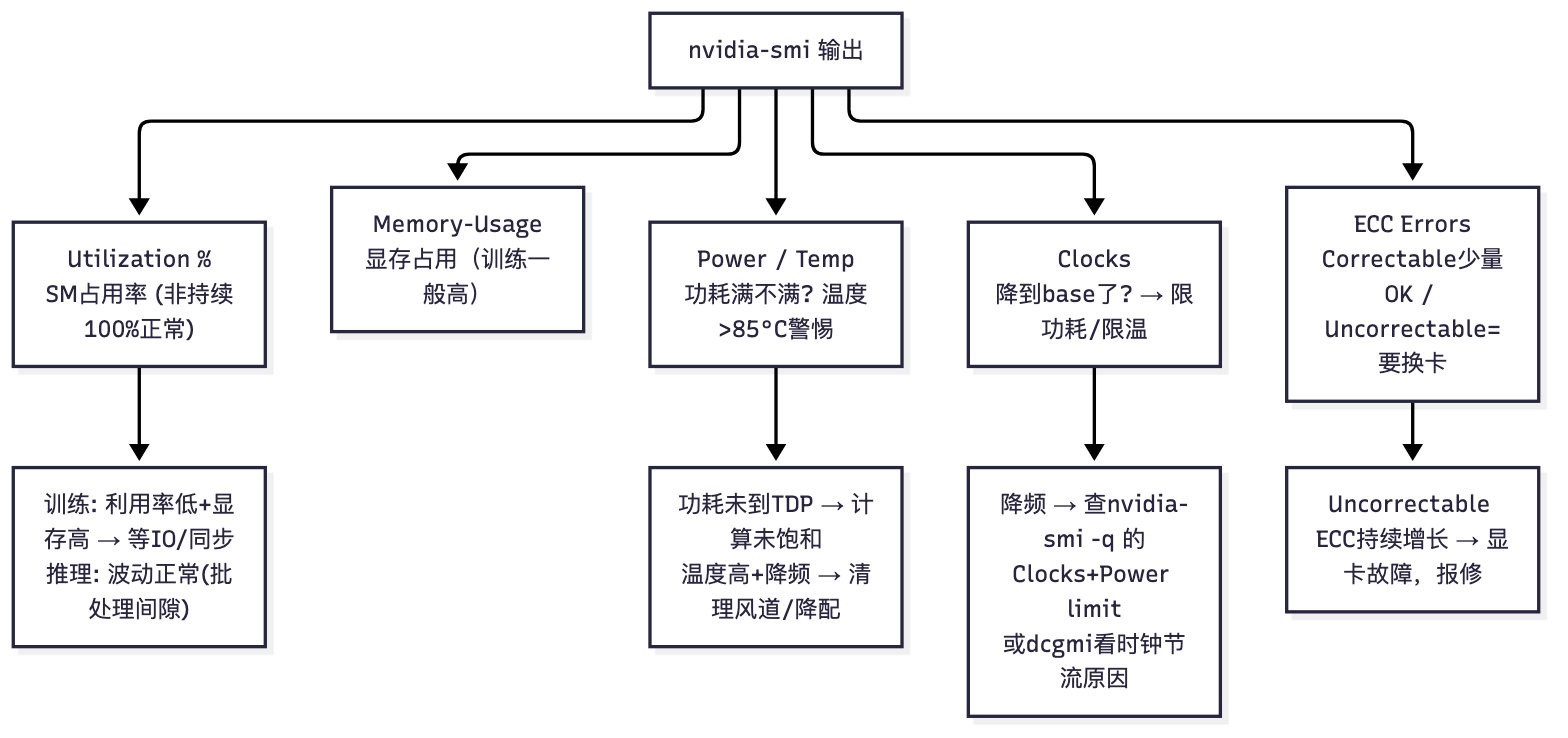
nvidia-smi 关键字段(你天天看,这里补含义):
- Utilization:SM 有 warp 在跑的时间占比。**不是”算力利用率”**——decode 阶段可能显示 30% 但已到带宽瓶颈
- Memory Usage:显存分配量。训练一般占满;推理看 KV Cache 余量
- Power:功耗接近 TDP 说明喂饱了电源;远低于 TDP 但 Utilization 高,多半 memory-bound(decode)
- Clocks:SM 时钟。降频第一原因是供电/温度限制(多见于机架超载散热不足)
- ECC Errors:volatile(当前会话)和 aggregate(累计)。Uncorrectable 不断增长 = 硬件故障信号
- Persistence Mode:关闭时 GPU 会因延时初始化慢 1-2s,且可能不跑任务时降功耗——集群里建议开(
nvidia-smi -pm 1)
常见故障映射(你的排障语言):
| 现象 | 背后硬件机制 | 排查动作 |
|---|---|---|
| 训练慢但 Utilization 高 | 同 SM 争用/调度抖动 / 小 kernel 太多 | 看 Power;试 CUDA Graphs;查 kernel 时长分布 |
| 推理慢且带宽吃满 | memory-bound(预期行为) | 量化/投机解码/PD分离(见 glossary-03) |
| XID 43 / 驱动重置 | GPU 上下文被杀或显存 ECC 错误 | dmesg 查 XID;换卡前先 nvidia-smi -q -d ECC |
| 多卡速度不随卡数线性 | NVLink 带宽或 NCCL 拓扑不对 | nvidia-smi topo -m 查拓扑;核对 NCCL 环境变量 |
| 温度 90°C+ 降频 | 散热/风道问题 | 检查风扇 PID、机架气流、带宽降配 |
要记住的数字(管理员版):
- PCIe Gen4 x16 ≈ 32 GB/s 单向(双向 64)——远低于 NVLink,跨机通信别走 PCIe 当主路
- NVLink:V100 300GB/s → A100 600GB/s → H100 900GB/s → B200 1.8TB/s(每卡)
- NVSwitch(8卡全互联):H100 算力 ~900GB/s 全对全,8 卡任意两卡直连
- ECC:HBM 带 ECC 是标配(A100 起);”aggregate ECC errors” 增长要警惕
- GPU kernel launch 开销 ~5μs;CUDA Graphs 可把它压到 ~1μs 且消除 CPU-GPU 同步等待
9. GPU 算力如何推算:从 spec 数字读懂硬件
核心公式(所有 GPU 通用):
1 | 理论峰值 FLOPS = SM数 × 每SM每时钟FLOPs × 时钟频率(Hz) |
验证:V100(完整的逐层验证)
1 | V100: 80 SM,每 SM 8 个 Tensor Core,每个 TC 每时钟 64 次乘加 = 128 FLOP |
验证:A100 / H100(反推每SM能力再乘回来)
1 | A100: 公式 = 108 SM × 每SM每时钟FP16 FLOP × 1.41GHz = 312 TF(官方) |
为什么喜欢直接查表而不是自己硬算:同样一张卡,FP16/BF16/FP8/FP4 的每SM能力差好几倍,
且品牌方公布数字基于特定精度、形状和时钟——硬算极容易差 20%。
你作为管理员真正有用的三件事:
- 训练总 FLOPs 估算(≈ 6 × 参数量 × token 数:前向3+反向3)
- Llama-3-8B 训 1T token:6 × 8e9 × 1e12 = 4.8e22 FLOPs
- H100 单卡理论 989 TF → 4.8e19 s ≈ 4.6 万卡时(100% MFU)
- 真实 MFU 40% → 除以 0.4 ≈ 11.5 万卡时——报预算/交期就按这个算
- 推理 FLOPs:每 token ≈ 2 × 参数(1 次前向)→ 8B 模型 ≈ 16 GFLOP/token
- MFU 反推:实测 TFLOPS ÷ 理论峰值(glossary-02 的公式这里解释物理含义)
要记住的:
- 公式:TFLOPS = SM数 × 每SM每时钟FLOP × 频率;不同精度相差 2-4 倍
- decode 别用算力算:它是带宽题(读 14GB ÷ 3.35TB/s),不是算力题
- 报训练成本用 6ND ÷ MFU 的口径,别用裸理论峰值康体型(会高估 2-3 倍)
10. 与路线图其它知识的接缝
| 本词鉴概念 | 接缝到哪 | 会在哪周用上 |
|---|---|---|
| Tensor Core / FP8 | glossary-01 的混合精度 16B/参数 | W2-W4 |
| HBM 带宽 → decode memory-bound | glossary-03 的 KV Cache 公式 | W11-W12 实测 |
| 带宽/算力比 | glossary-02 的 MFU 分析 | W9 算 MFU 时解释为什么上不去 |
| NVLink/NVSwitch | glossary-02 的 TP 只在机内 | W8 配 TP 时看拓扑 |
| Roofline | glossary-03 推理瓶颈定性 | W12 vLLM 压测分析 |
| nvidia-smi / ECC / XID | phase4 的 W18 故障复盘 | W18 直接排你的真实事故 |
记忆锚点:GPU = 一万个只会算数的 Worker(SM)+一个超大内存对象(HBM)+每层之间的高速缓存。
训练吃 Tensor Core(算力),推理 decode 吃 HBM(带宽),并行跨卡吃 NVLink——三种”资源”看的指标完全不同。