词汇图鉴 ③ — 推理服务的核心矛盾 + RL 是什么(服务层)
这一层回答:一个训练好的模型,怎么变成”毫秒级响应”的服务?
为什么推理的瓶颈和训练完全不同?RL 训练又在同时用前两份图鉴的什么?
前置:词汇图鉴①(Attention/causal mask/KV)和②(并行/通信)。
0. 先记住推理的总矛盾
1 | 训练: 吃显存的大户 = 权重 + 梯度 + 优化器状态 + 激活 (并行切分主角) |
推理没有反向传播、没有优化器——GPU 只做前向。但每个请求都要占一份 KV Cache,
请求多了,KV Cache 比模型权重还占显存。所以推理引擎本质是
**”KV Cache 的内存管理器 + 请求调度器”**。
1. Prefill 与 Decode:一个请求的两个阶段
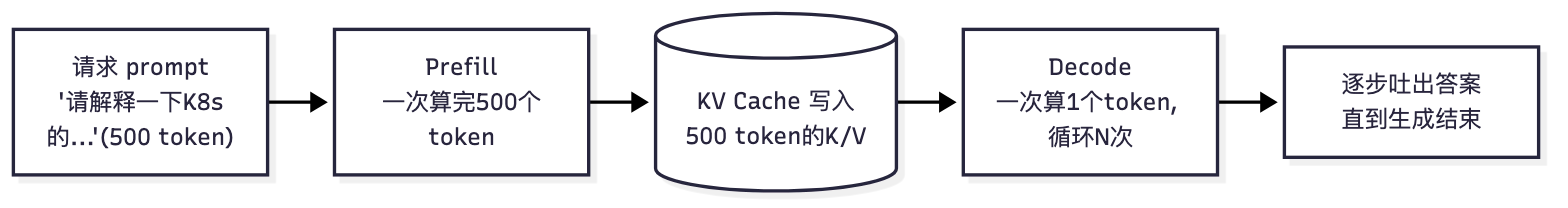
| 阶段 | 干什么 | 瓶颈 | 类比 |
|---|---|---|---|
| Prefill | 把整段 prompt 一次性算过,写入 KV Cache | 算力(矩阵乘大) | 一次编译整个文件 |
| Decode | 逐 token 生成答案,每步只算 1 个新 token | 显存带宽(要重读权重+KV) | 一行行读文件输出 |
为什么 decode 是 memory-bound:每生成 1 个 token,需要把全部权重
从 HBM 读一遍做矩阵乘——读 14GB(7B fp16)的权重只产生 1 个 token。
GPU 算力再强也在等内存喂数。
数字直觉:H100 显存带宽 ~3.3TB/s,7B fp16 权重 14GB,
理论上限 ≈ 3.3TB / 14GB ≈ 每秒 ~236 个 token——这是”单请求 decode 速度
被硬件钉死”的根源,想提速要么量化(权重变小)、要么同时处理多个请求
(批处理,让读进来的权重被更多请求共享)。
2. KV Cache(键值缓存)
是什么:Decode 每步只新增 1 个 token 的 K/V,但 attention 需要”过去所有 token
的 K/V”。与其每步把历史全重算(training 式),不如缓存每层的 K/V 向量。
为什么合法(回到词汇图鉴①的 causal mask):新 token 只依赖历史,
历史 token 的 K/V 计算不依赖新 token → 结果不变,可以缓存。
大小公式(必背):
1 | KV Cache大小 = 2(K和V) × 层数 × KV头数 × head_dim × seq_len × 请求数 × 字节数 |
- Llama-3-8B(32层, 8 KV头, 128 head_dim, bf16):
2 × 32 × 8 × 128 × 2B = 128 KB / token→ 8K 上下文单请求 = 1 GB KV Cache; - 权重只有 16GB,但并发 100 个请求 × 8K 上下文 = 100GB KV Cache,
比权重还大——这就是 GQA/MLA(词汇图鉴①)存在的理由,也是 PagedAttention 的目标。
系统类比:动态规划的备忘录(memoization)——算过的不重算。
但“缓存”是每个请求独占、会膨胀的,所以下一节的内存管理才这么关键。
3. FlashAttention:让 attention 少搬数据
一句话:传统 attention 把中间结果(N×N 分数矩阵)反复写回显存(HBM),
FlashAttention 把所有步骤在线算完、留在片上高速缓存(SRAM),只在最后写回一次。
1 | 传统: QK^T → 写显存 → softmax → 写显存 → ×V → 写显存 (多次HBM往返) |
系统类比:CPU 缓存友好的矩阵分块(cache blocking)——把访存量大的算子
留在最快的内存层级里算。对训练(激活显存从 O(N²) 降为 O(N))和长上下文推理
都至关重要。
4. PagedAttention 与 vLLM(分页管理 KV Cache)
问题:朴素实现给每个请求预先分配连续显存存 KV Cache:
- 不知道生成多长 → 过度分配(内部碎片 = 预留未用);
- 多个请求的缓存块无法复用 → 外部碎片;
- KV Cache 浪费率可达 60-80%。
vLLM 的答案(PagedAttention):像操作系统的虚拟内存一样,
把 KV Cache 切成固定大小的小块(block,如 16 个 token 一页),按需分配、
物理上不要求连续:
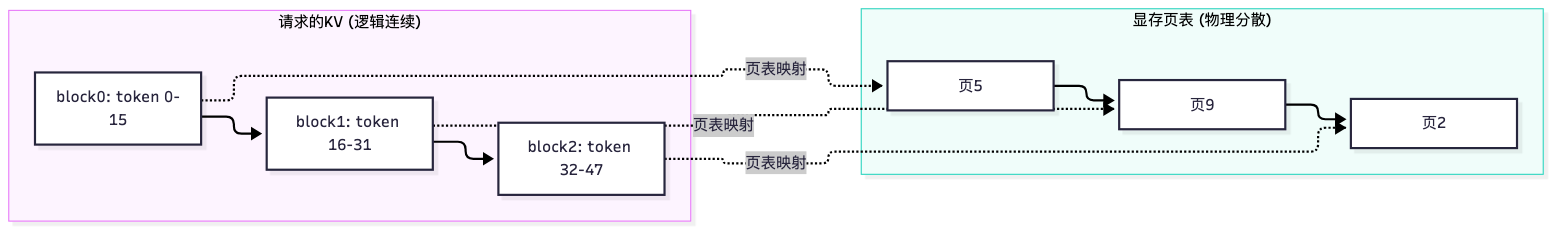
- 只分配实际用到的页 → 几乎消除内部碎片;
- 物理页还能被多个请求共享(同样前缀的 prompt 共用前缀页);
- 显存利用率从 60% 提升到 90%+,吞吐提升可达 10-24 倍(论文数据)。
系统类比:虚拟内存的请求分页(demand paging)——进程(请求)不按
“逻辑上连续”预留物理内存,缺页才分配、页可共享(copy-on-write 的前缀共享,
实际上前缀共享更像共享库的页面)。vLLM 的 scheduler 就是”内存分配的
虚拟内存管理 + 进程调度器”二合一。
5. Continuous Batching(连续批处理 / 迭代级调度)
问题:传统 static batching 一批请求齐进齐出——先来的请求要等慢的
(生成到一半的请求占着坑,新请求进不来),GPU 有空转。
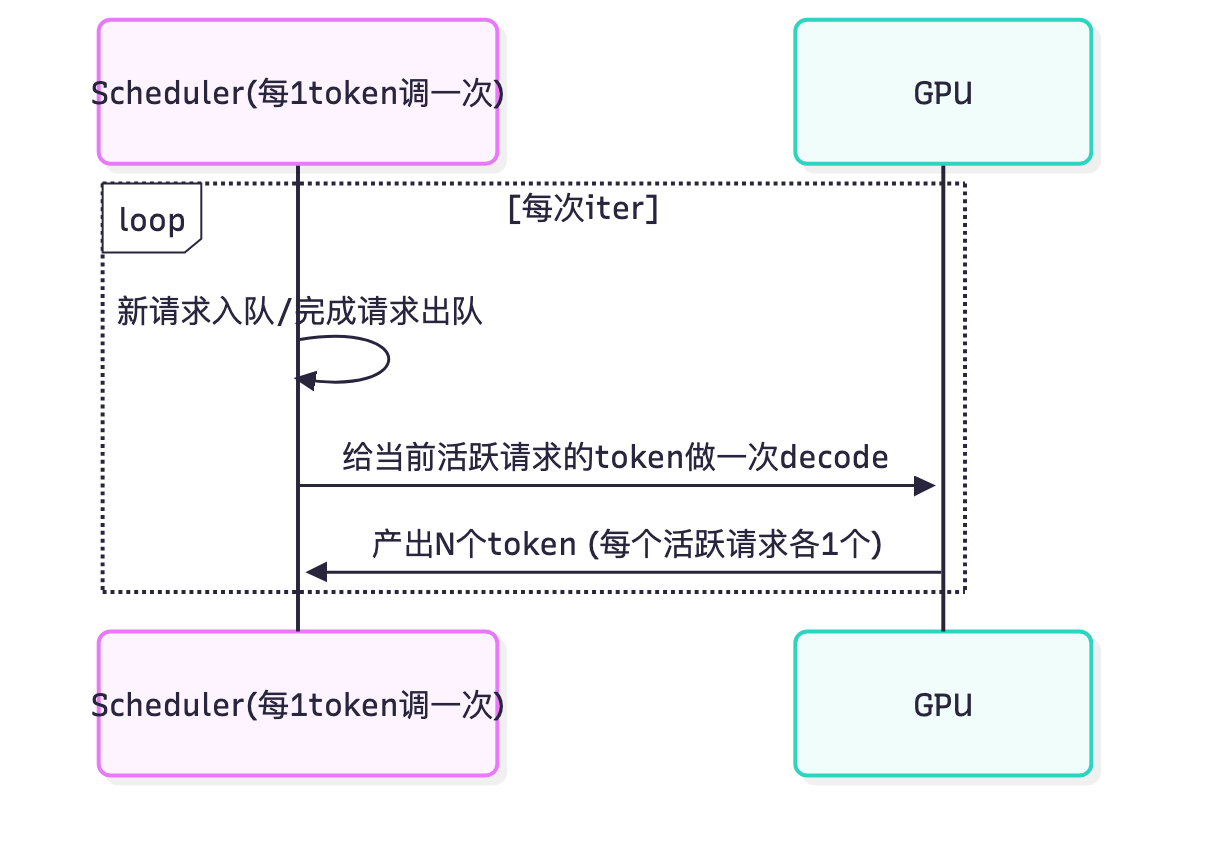
Continuous Batching:把调度粒度从”整批”降到”每次迭代(每生成1个token)”:
- 每个请求独立推进,生成完的立刻出队,腾出的位置立刻进新请求;
- 每步都重新选一批”当前活跃请求”一起算(动态组合 batch);
- 这是所有现代引擎(vLLM/SGLang/TGI)吞吐高的核心。
系统类比:绝对公平/最短作业优先的 CPU 进程调度——请求 = 进程,
每次时间片 = 一个 token 迭代;区别是这里”进程”可以中途换入换出
(抢占式 = 普通连续性调度)。调度策略 + 显存管理(KV Cache)就是推理
引擎的全部灵魂——你现在已经能看懂 vLLM 的 scheduler 参数在调什么了
(Phase 3 W12 实操)。
6. 量化(Quantization)
是什么:用更低精度存权重(FP16→INT8→FP4/FPS8)来换显存和速度。
| 精度 | 权重字节/参数 | 相对FP16 | 典型场景 |
|---|---|---|---|
| FP16/BF16 | 2B | 1x | 基准 |
| INT8/FP8 (weight-only) | 1B | 减半显存,decode 提速 | 生产主力 |
| INT4 (GPTQ/AWQ) | 0.5B | ¼显存 | 大模型塞进小卡 |
为什么 decode 提速:decode 是 memory-bound——权重占内存越小,每 token
读的数据越少,生成越快;训练侧也能用 FP8(减少通信和显存,DeepSeek-V3 就用了)。
代价:精度损失 → 需要校准(GPTQ/AWQ 用一小批数据调量化参数)+ 评估质量。
系统类比:图片/音频压缩——体积小、加载快,但画质(精度)有损;
你可以选择”对它影响小的地方多压”(如 GPTQ 按通道灵敏度分配位宽 ≈ 感知量化)。
7. 投机解码(Speculative Decoding)
问题:decode 每步都在”读全部权重只生成1个 token”,算力闲着。
思路:用一个小草稿模型(draft)先快跑几步生成 N 个候选 token →
大模型一次性校验这批候选(一个 forward 并行检查 N 个 token 是否合格)→
合格的就接受。”用草稿模型的速度 + 大模型的正确性”。
1 | draft模型快速猜: [t1,t2,t3] → 大模型一次校验3个 → 接受2个 → 平均每步产出2个token |
系统类比:git 的”先缓存后校验” / 写时复制优化?更贴切:CPU 的
分支预测 + 乱序执行——先大胆猜(draft),猜对被并行验证(大模型批量检查),
猜错回滚(rejection sampling 保证输出分布不变)。
8. PD 分离(Prefill/Decode 分离)
动机:prefill 吃算力、decode 吃显存带宽——混在一起互相拖累:
- prefill 的稠密矩阵乘和 decode 的稀疏 KV 读取混在同一个 GPU 上,利用率互相干扰;
- 长 prompt 的 prefill 会阻塞 decode 的实时性(TTFT 高)。
做法:prefill 实例和 decode 实例分成不同的 GPU 池(算力卡 vs 显存带宽卡),
prefill 完的 KV Cache 经高速网络转交给 decode 实例继续生成:
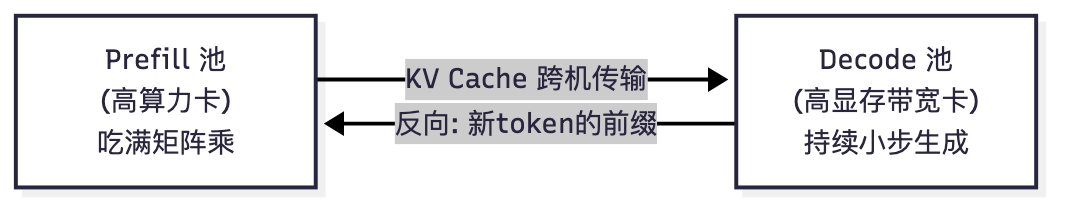
- 好处:两池各自极致利用、隔离故障、可独立扩缩容;
- 代价:KV Cache 要跨机搬(网络开销)、调度复杂度上升;
- 这是 NVIDIA Dynamo 等新一代推理框架的主推架构,也是 2025-2026 推理侧的
主流方向(对应你选的重点方向三)。
系统类比:把”编译(静态大活)”和”流式输出(实时小活)”拆到两个集群,
各配各的机型——像 CDN 里”冷启动缓存预热”和”持续服务”分流。
9. 前缀缓存 / 模型路由 / 推理网关
- 前缀缓存(Prefix Caching):多个请求共享同一段 prompt 前缀(如 system prompt、
few-shot 示例)时,复用那份 KV Cache——RadixAttention(SGLang)把前缀组织成
树(字典树),公共前缀只存一份,命中率更高; - 模型路由(Semantic Routing):按请求难度把请求分给不同大小/成本的模型
(简单问题→小模型),省成本; - 推理网关(AI Gateway):类似 API 网关——鉴权、限流、fallback、缓存、计费,
前面挂多个模型后端。
系统类比:前缀缓存 = HTTP 的 shared cache / 共享库页面;
网关 = 流量入口治理(K8s 的 Ingress/网关那一套,你熟)。
10. RL(强化学习):训练与推理的”交汇点”
为什么你需要懂 RL:RL 后训练同时是推理问题和训练问题——
它把两个系统串成一个循环,是你两份图鉴知识的交汇点(Phase 5 W21 深入)。
RLHF/GRPO 循环的骨架
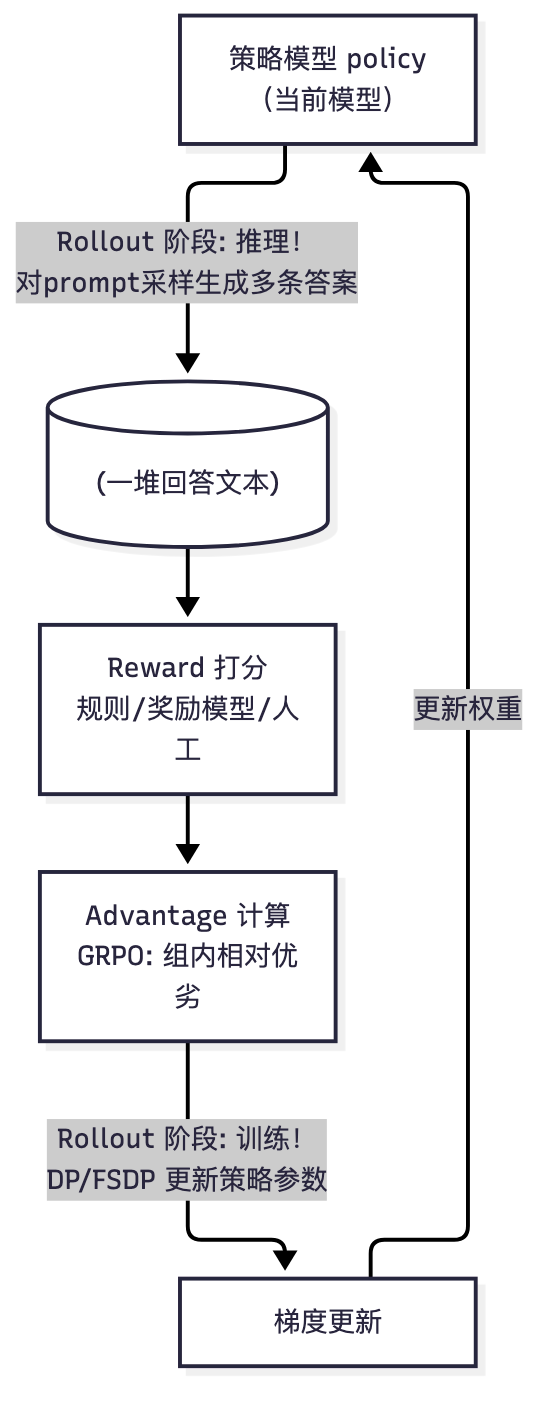
- Rollout(推理侧):用当前模型生成大量样本——本质是一次大规模推理服务
(走词汇图鉴③的技术:batching、KV Cache、采样); - Reward(打分):规则(如数学题对错)或奖励模型判断答案质量;
- Policy Update(训练侧):用这套”问题-答案-分数”数据训练模型,
让高分答案概率上升——本质是分布式训练(走词汇图鉴②); - 循环往复:模型变好 → 重新 rollout → 更好……直到收敛。
PPO vs GRPO vs DPO(必懂区别)
| 算法 | 需要额外模型? | 核心思想 | 典型代表 |
|---|---|---|---|
| PPO | 需要 value 模型(critic,另一份权重) | 策略+价值双网络,逐样本算优势 | RLHF 经典 |
| GRPO | 不需要 critic | 同一 prompt 采样 G 条回答,用组内相对优劣算优势,省掉价值模型的显存和训练 | DeepSeek-R1/V3 |
| DPO | 完全不需要 RL 循环 | 直接用偏好数据(好/坏回答对)做监督式优化 | 轻量对齐 |
系统类比:PPO = 需要”裁判模型”给每个动作打分(双网络);
GRPO = 同一问题生成多个答案”小组内互评”,省一个模型;
DPO = 拿标注好的”正确答案 vs 错误答案”直接学,不走交互采样。
工程含义:GRPO 训练里的 rollout 通常用 vLLM 之类引擎跑(推理系统),
权重更新用 FSDP/ZeRO(训练系统)——两个系统要协同,你就知道为什么
“推理+训练混合调度”是当前 AI infra 的最大工程课题了。
11. 词汇图鉴①→③ 串起来的总图(建议把这张记进脑子)
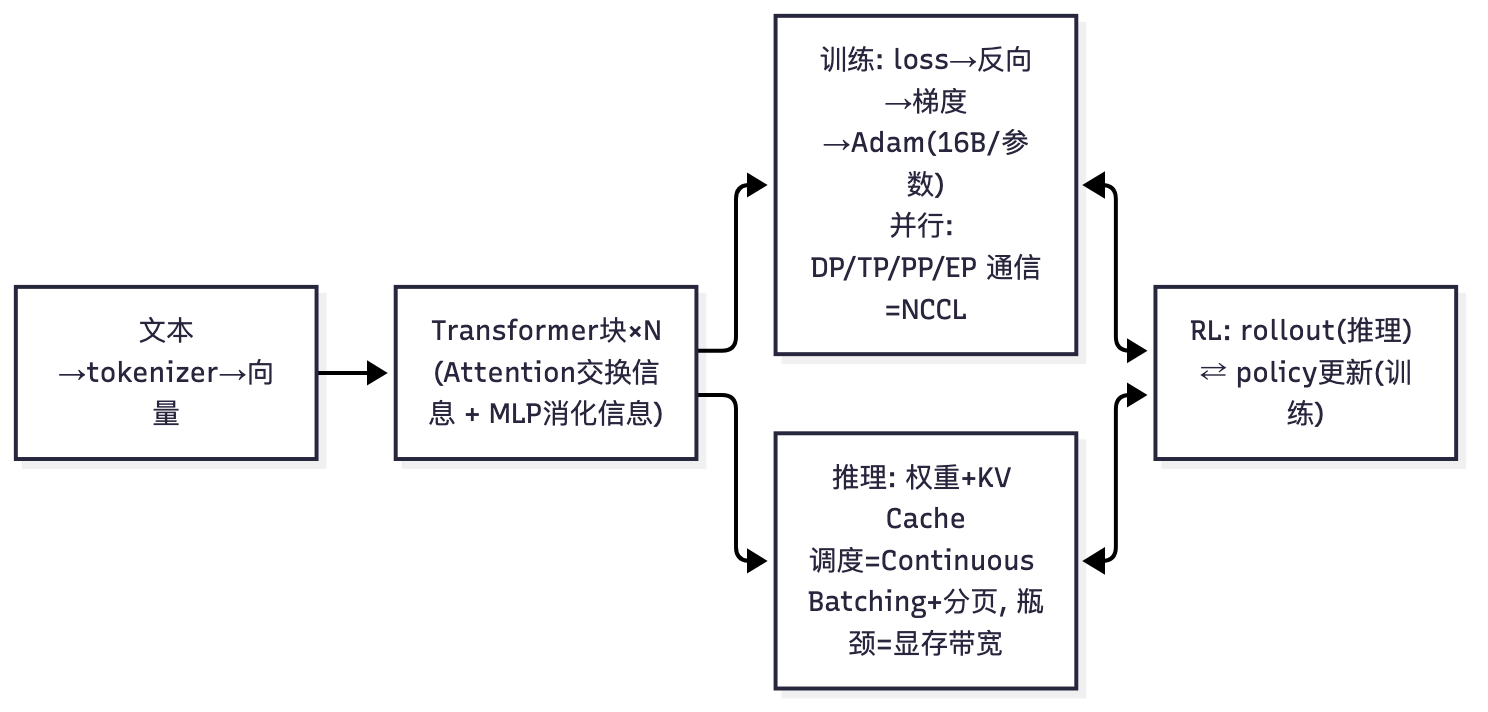
自测清单(每张图都能用自己的话讲一遍再进入下一阶段):
- token 从文本到最终概率,经过哪几步?为什么 attention 是 O(N²)?
- 训练显存 16B/参数怎么来的?DP/TP/PP 各切什么、各产生什么通信?
- decode 为什么慢?KV Cache 多大?PagedAttention/Continuous Batching 解决什么?
- GRPO 循环里,哪部分吃训练系统知识、哪部分吃推理系统知识?