词汇图鉴 ② — 训练是怎么"铺开"到多卡的(扩展层)
这一层回答:为什么训练必须用很多 GPU?并行策略到底在切什么?
每一刀切下去产生什么通信?出问题该查哪里?
前置:已读词汇图鉴①(特别是”16B/参数”和显存总账)。
0. 两个动机:为什么要多卡
1 | 动机A — 显存放不下 (capacity):7B 模型训练要 112GB 参数+状态,单卡放不下 |
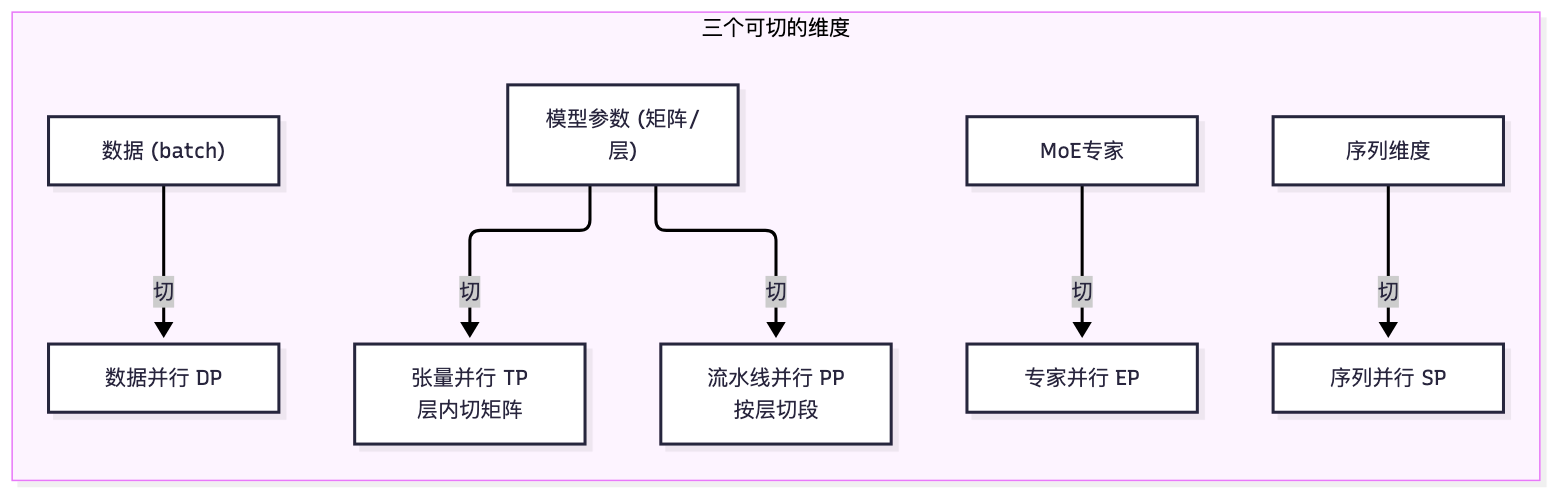
所有并行策略 = 对”参数、数据、计算”三个东西做切分,切法不同 → 通信不同。
1. 通信原语:先认识这三个”搬运操作”
所有并行策略最终都编译为这几种集合通信(NCCL 里的 collective):
| 原语 | 输入→输出 | 类比 | 用在哪 |
|---|---|---|---|
| AllReduce | 每卡有 partial → 每卡都拿到 sum/avg | 全班作业汇总(每个人最后都有全班总分) | DP 梯度平均 |
| AllGather | 每卡有我的一块 → 每卡都有全部 | 把分片收集回全量 | FSDP 取权重、TP 输出拼接 |
| ReduceScatter | 每卡有我的一块 → 每卡拿到聚合后的一部分 | 先汇总再按份分发 | ZeRO-2 梯度分片 |
Ring AllReduce 内部(NCCL 默认实现,带宽利用率 ≈ 2(N-1)/N):
1 | GPU0 ──> GPU1 ──> GPU2 ──> ... ──> GPU(N-1) ──> GPU0 (把数据切成N块, 环形传递累加) |
系统类比:AllReduce ≈ MapReduce 里的”汇集阶段(shuffle + reduce + broadcast)”,
环形实现 = 环形令牌传递式通信,避免中心节点成为瓶颈。
排障要点:NCCL 对网络延迟、带宽、链路错误极其敏感——一条坏线就会拖垮整个
ring(这就是 Phase 4 W17 要在集群上跑 nccl-tests 的原因)。
2. DP(数据并行)— 最简单,先吃透
1 | GPU0 模型副本 + batch[0:16] GPU1 模型副本 + batch[16:32] |
- 每卡一份完整模型(显存没省,反而翻倍),只切 batch;
- 训练步末做一次梯度 AllReduce(通信量 = 2 × 参数量 × 4字节 × 2次传递);
- 通信与反向计算可以 overlap(DDP 按 bucket 边算边传,隐藏通信延迟)。
scaling efficiency 公式(Phase 2 W6 要实测的):
1 | 理想吞吐 = 单卡吞吐 × 卡数 |
卡越多,梯度 AllReduce 越频繁、网络越吃紧,效率必然下降——通常 4~8 卡内接近线性,
再往上要看网络。
系统类比:DP = 多台 web 服务器各跑完整应用实例,前面挂负载均衡(分 batch),
每轮处理完通过一致协议同步状态(梯度 AllReduce)。
3. TP(张量并行)— 把单个矩阵切开
模型太大放不进单卡时,把层内的矩阵切开分到多卡,每卡算一块,算完拼回去。
以 MLP 为例(为什么 up 列切、down 行切——你 Phase 2 W8 要亲手推一遍):
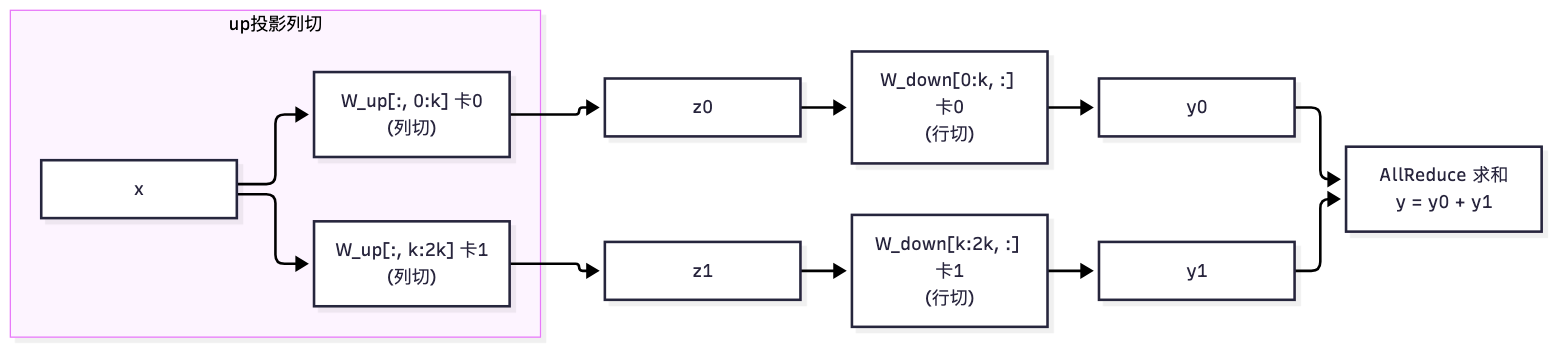
- 列切 up:每卡算一部分隐藏单元(无需通信,并行度高);
- 行切 down:每卡输出的部分和需要 AllReduce 相加 才能还原完整输出;
- 所以 TP 的每一步前向都要通信 → TP 一般只用于机内/NVLink 高速互联内
(跨机延迟太高会浪费)。
系统类比:TP = 把一个大文件分块存储在多台机器并行计算,每算一步都要
“reduce 汇总一次”——像分布式 SQL 里的 exchange 算子,通信频繁。
NVLink(机内 900GB/s 级)≈ 高端内存带宽;InfiniBand(跨机 400Gbps 级)≈ 网卡,
差一个数量级——所以 TP 不该跨机。
4. PP(流水线并行)— 把层切成段
模型按”层”竖切成 P 段,每段的计算放在不同 GPU/节点上,数据像流水线一样往下流:

- 流水线需要把 batch 切成多个 micro-batch 依次灌入,才能让后段卡不闲着;
- 气泡(bubble):灌入/排空阶段,前段后段卡空闲的比例 ≈ (P-1)/M
(P=段数, M=micro-batch 数)——M 越大气泡越小; - 现代调度(1F1B)让”前向一个 batch 后立刻反向一个 batch”交错推进,进一步压气泡;
- 关键点:PP 只传输”层与层之间的激活”(很小),通信量远小于 TP/DP,
所以 PP 是跨机训练的默认选择。
系统类比:工厂流水线——分工越细(段多)产能越高,但工件传递(激活)要在
工位之间流转,且开机/停机阶段有空转(bubble)。
5. EP(专家并行)+ MoE 复习
MoE 模型(DeepSeek-V3 类)里,一个 transformer 层有 N 个”专家”MLP,
每个 token 只激活 top-k 个(DeepSeek-V3:671B 总参数,每 token 只激活 37B)。
1 | token → 路由(router):这个 token 归专家2和专家7处理 |
- 参数量巨大但激活少 → 推理快、省显存;
- 训练/推理时专家切到多卡 = EP,token 跨卡路由 → All-to-All 通信
(比 AllReduce 更”散”的通信用法); - 负载均衡是关键工程问题(某专家被疯狂路由就成热点)——DeepSeek-V3 用
无辅助损失的负载均衡策略,就是为了避免”为均衡而均衡”损质量。
系统类比:EP = 镜像仓库换成”N路分片缓存”——请求(token)按 hash 路由到
对应的后端节点,节点间靠内部网络搬数据(all-to-all)。
6. SP(序列并行)— 切序列维度
把 (seq_len, d_model) 的序列维切开,配合 TP 一起用,
主要是为了降低激活显存(长上下文场景下激活可能比权重还大)。
Ring Attention 是它的进阶版(把序列切到多卡循环处理,支持超长上下文)。
7. 3D 组合:DP × TP × PP(真实训练的主流形态)
单机 8 卡、跨机训练时,三层并行叠加:
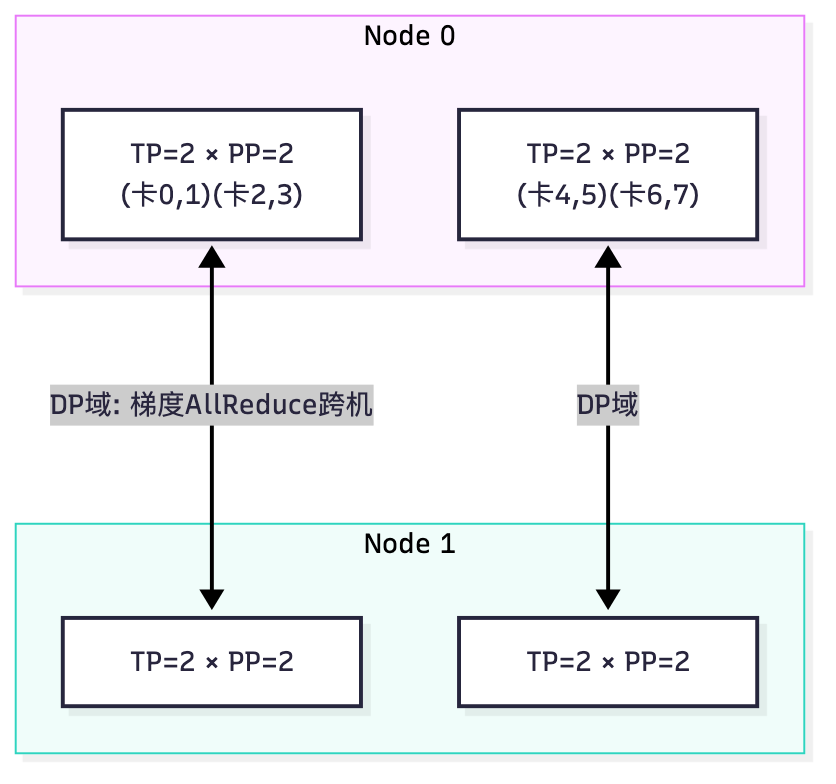
组合原则(记忆口诀):
- TP 只走机内(NVLink,通信最频繁);
- PP 走机间(通信量小,跨机开销可控);
- DP 走机间(梯度 AllReduce 频率 = 训练步频,每步一次,可控)。
选型 = 在”显存够不够放”与”通信开销”之间权衡:
梯度 AllReduce(DP)通信量与模型大小成正比;TP/PP 通信量随切分增大。
给定模型和硬件算 “DP×TP×PP” 怎么配,是 Phase 2 W9 的实战题。
8. ZeRO 与 FSDP:如何用分片换显存
问题:DP 每卡都存全量”权重+梯度+优化器状态”,7B 模型 = 每卡 112GB,浪费且装不下。
ZeRO 的答案:不再每卡存全量,而是分片存储,用时再聚合。
| 阶段 | 分片对象 | 每卡显存变化 | 带来的通信 |
|---|---|---|---|
| ZeRO-1 | 优化器状态(m,v) | 省约 12B/参数 × (N-1)/N | 无额外通信(梯度还是每卡全量) |
| ZeRO-2 | + 梯度 | 梯度也分片 | ReduceScatter 梯度 + AllGather 参数 |
| ZeRO-3 | + 参数本身 | 权重也分片,最省 | 前向/反向每层都 AllGather 权重(通信最重) |
1 | ZeRO-3 单卡显存 ≈ 16B × 参数量 / N (+ 激活) |
系统类比:DP = 每台机器存全量数据副本(冗余);
ZeRO-3 = 分布式存储/分片文件系统——数据打散存在 N 台机器,用时现取现拼
(AllGather),换来的是每次都多一次网络取数→通信换显存。
FSDP = ZeRO-3 在 PyTorch 里的原生实现(fully_shard),和 ZeRO 的区别主要是
工程形态:FSDP 更 PyTorch 原生、易用;DeepSpeed ZeRO 附带更多高级功能
(offload 到 CPU/NVMe、通信压缩等)。工程上两者二选一即可,
原理完全一致。FSDP2 又做了按参数切分粒度等改进。
选型直觉(Phase 2 W7 用实验验证):
- 模型能塞进单卡 → DP 最划算(通信最少);
- 塞不下但小集群 → FSDP/ZeRO-3(省显存,代价是通信);
- 超大模型跨机 → TP+PP 为主(把通信压进 NVLink 域),ZeRO 做梯度/状态分片。
9. Checkpoint(训练存档)与恢复
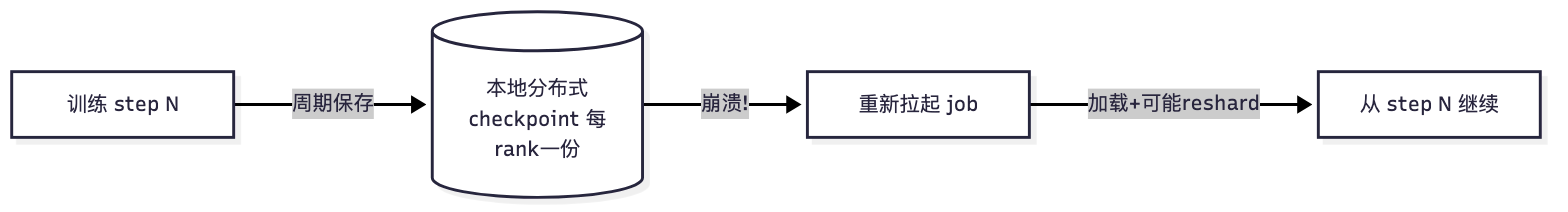
是什么:周期性把训练状态(权重、优化器状态 m/v、学习率、step、随机种子)落盘,
崩溃后从最近的存档继续——否则跑两周的任务一个 OOM 就白干。
为什么分布式 checkpoint 难:
- 每个 rank 的模型分片和优化器状态不同 → checkpoint 必须按 rank 存,还要记录”切分方案”;
- 换 GPU 数量恢复(4卡存 → 2卡恢复)需要 resharding(重切);
- 大模型 checkpoint 动辄几十~几百 GB → 落盘慢,可能拖停训练 → 需要
异步 checkpoint(后台拷贝,训练不阻塞)。
系统类比:数据库的 WAL/备份策略——savepoint 频率 = checkpoint 间隔,
要在大故障损失(间隔太长)与开销(太频繁拖慢训练)之间权衡。
在 K8s 上的体现:JobSet/失败重试 + 存储挂载(PVC/对象存储)决定 checkpoint
写哪、写多快——这是你作为管理员最熟悉的战场(Phase 2 W10 实战)。
可靠性数字(Phase 5 W22 会用到):万卡集群上故障几乎是常态,
业界经验是”几百卡规模、几小时无失败,几千卡规模、错误率以小时计”——
checkpoint 频率和恢复时长(MTTR)直接决定 goodput(有效产出/总时间)。
10. 一张图总结:训练流程里的资源流
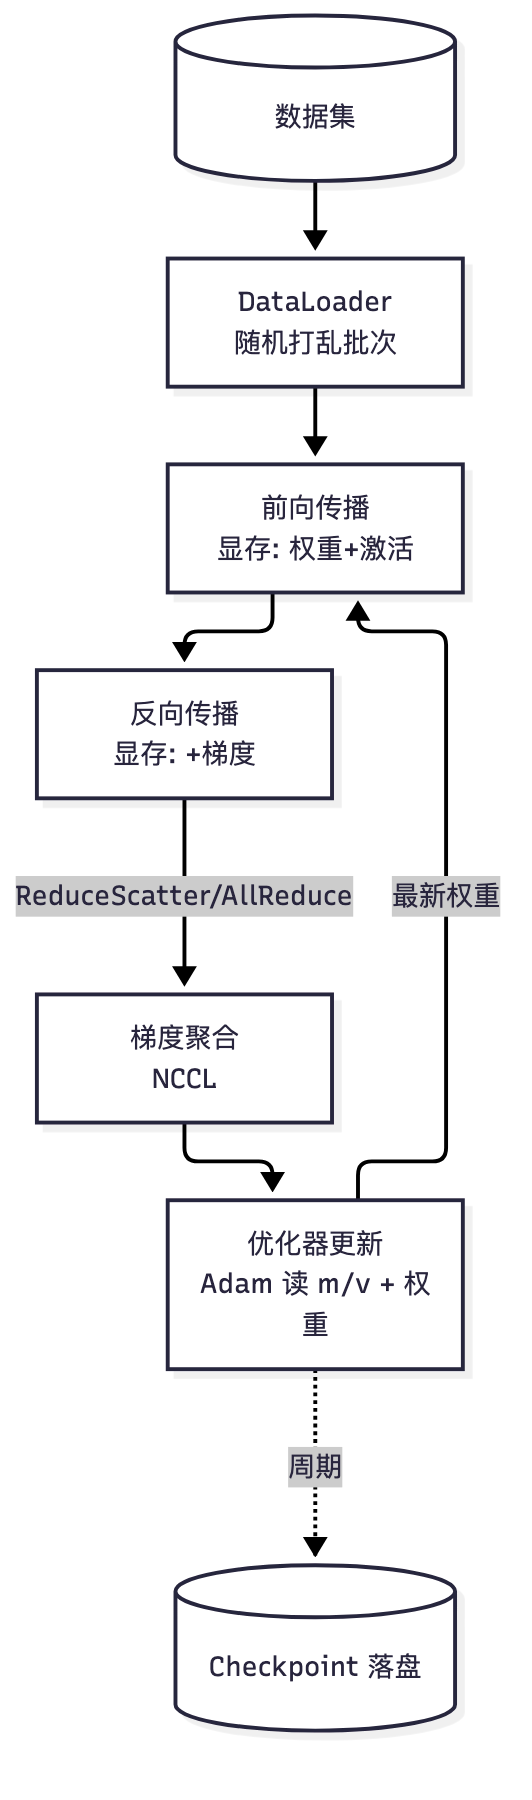
现在你已能回答:训练任务里每部分显存是啥、通信发生在哪、为什么卡越多
通信越重、checkpoint 为什么是长训练的命门——这些就是 Phase 2 全部实验的主角。