词汇图鉴 ① — 模型在"算"什么(计算语义层)
这一层回答:一次训练/推理,GPU 上到底在做什么数学运算?
面向读者:系统工程师。每个概念用你熟悉的系统思维来类比。
建议:每读完一节,合上书把图示默画一遍,再对照。
0. 全局图:一个 token 在模型里的旅程

记忆锚点:文本进模型 = 一串数字进来,经过 N 层”交换信息+消化信息”的循环,
最后变成”下一个词的概率表”。
1. Tokenizer(分词器)
一句话:把自然语言切成模型能处理的”词元(token)”,每个 token 对应词表里的一个整数 id。
内部做了什么(以 GPT 系用的 BPE / Byte-level BPE 为例):
- 把文本按 Unicode 解码成字节序列;
- 统计相邻字节对(byte pair)出现的频率,把最高频的一对合并成一个新符号;
- 重复合并,直到词表达到目标大小(GPT-2 是 50,257,Llama-3 是 128,256);
- 得到一个合并规则表,运行时按规则贪心切分。

系统类比:Tokenizer 像”压缩算法的字典 + 最短前缀匹配的分词器”。
输入变短了(一个 token ≈ 4 个字符、约 0.75 个英文单词),模型的计算量就小得多。
注意:它不是按词切——“hello” 和 “hello!” 会拆成不同的 token 组合,
而且分词粒度和数学能力直接相关(”3+5” 拆成 1 个 token 还是 3 个 token,影响数感)。
要记住的数字:约 4 字符/token、约 0.75 英文单词/token;
中文约 1 字 ≈ 1~2 个 token(中文字符在 byte-level BPE 下通常 1-2 token)。
2. Embedding(嵌入层 / 查表)
一句话:把 token id 映射成一个固定维度的稠密向量(如 d_model=4096),
让”意思相近的词”在向量空间里距离近。
内部做了什么:就是一个查表(lookup table)——一个形状为 (vocab_size, d_model)
的权重矩阵,第 i 行就是 token id = i 的向量。几乎不花算力,花的是显存。
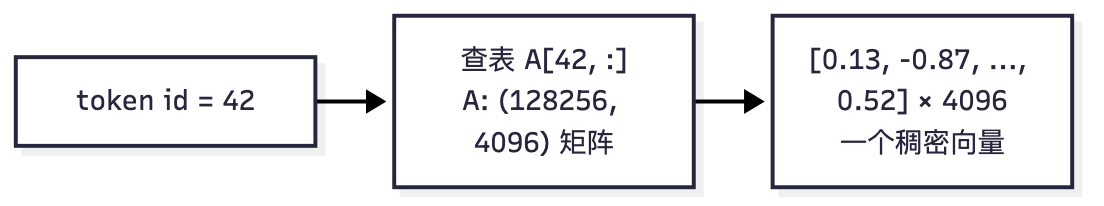
系统类比:像一张 (key=id) → (value=vector) 的哈希表 / 内存查找。
也可以理解为把 one-hot(128256 维、只有1个1)乘以嵌入矩阵,得到压缩表示——
但实践中直接取行,不做矩阵乘。
要记住的:Embedding 矩阵参数 = vocab_size × d_model。
Llama-3-8B:128,256 × 4096 ≈ 5.25 亿参数,占总参数约 6%(不算很小的开销)。
3. 位置编码(Position Encoding / RoPE)
一句话:attention 本身不知道词的顺序(它是集合运算),需要显式注入位置信息。
内部做了什么:
- 绝对位置编码(GPT-2):学一个位置 embedding 表,加到 token 向量上;
- RoPE(旋转位置编码,Llama/Qwen 系标配):把 Q 和 K 向量按位置做旋转变换,
使”两个 token 的点积”自动带上”相对位置”的相位差——位置信息进到 attention 分数里。
系统类比:像给数据包加序列号(绝对位置),而 RoPE 更像用”相位的相对差”
编码时序(类似 OFDM 的相位调制),好处是外推性更好——
训练时见过的位置范围之外,RoPE 也能平滑工作。
4. Attention(QKV 注意力)— 全文最重要的一块
一句话:让每个 token 去”看”序列里所有其他 token,按相关性加权汇总信息。
内部做了什么(单头缩放点积注意力):
- 每个 token 的向量 x,通过三个线性变换得到 Q(查询)、K(键)、V(值);
- 用当前 token 的 Q 和所有 token 的 K 做点积 → 相似度分数;
- 除以 √d_k 缩放(防止 softmax 饱和),做 softmax → 权重(和为 1);
- 用权重对所有 V 加权求和 → 输出向量。
1 | K1 K2 K3 K4 (序列里所有键) |
系统类比:这就是一次数据库/检索操作——Q 是”查询条件”,K 是”索引/主键”,
V 是”要取的数据行”。token 的 Q 去和所有 K 匹配相似度,把最相关的 V 加权取回来。
注意力权重矩阵形状是 (seq_len, seq_len),这就是”二次复杂度 O(N²)”的来源,
也是长上下文显存爆炸的根源。
Causal Mask(因果掩码):训练时让 token 只能看到自己及之前的 token
(未来是”答案”,不能偷看)——分数矩阵右上三角置 -∞,softmax 后变 0:
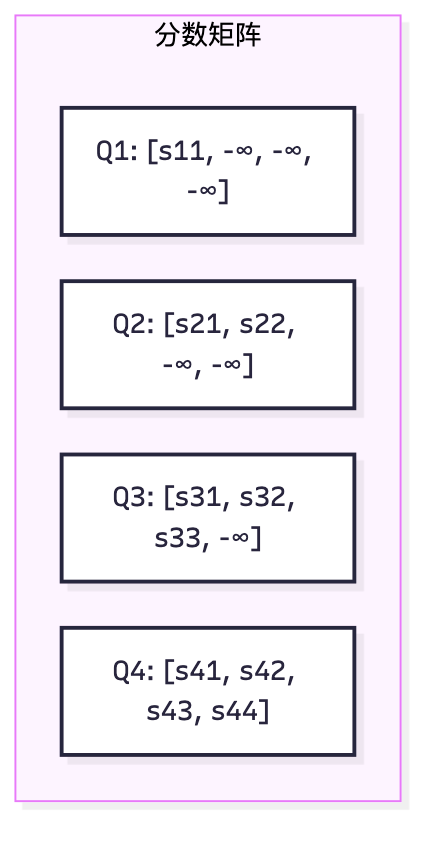
关键伏笔:mask 决定了”新 token 只依赖历史,历史不依赖新 token”——
这就是推理时 KV Cache 合法的根本原因(见词汇图鉴③)。
5. Multi-Head / GQA / MQA / MLA(多头与各类变体)
Multi-Head:不是用一个 Q/K/V 大向量算一次,而是切成 n_head 个头,每个头在
不同表示子空间上独立做 attention,最后拼起来再投影。像多个”关注点”并行工作,
有的头学语法、有的头学指代、有的头学位置。
变体都在解决同一个问题:KV 太多,推理显存太贵。
| 变体 | KV 头数 | 说明 | 典型使用 |
|---|---|---|---|
| MHA(多查询) | = Q 头数(每个头自己的 K/V) | KV cache 最大 | GPT-2、Llama-2 |
| GQA(分组查询) | Q头数/G(如 32→8) | 组内共享 K/V,KV cache 缩 4 倍,质量损失小 | Llama-3、Qwen |
| MQA(多查询) | = 1(所有 Q 头共享一份 K/V) | KV cache 最小,质量损失略大 | 早期推理优化 |
| MLA(多头潜在) | 不存展开的 K/V,存一个低秩压缩向量,使用时再解压 | KV cache 压缩最狠(DeepSeek 系) | DeepSeek-V2/V3 |
要记住的:这些是架构层面为”推理显存”做的妥协——你在 Phase 1 W5 亲手实现过 GQA,
在 Phase 3 会亲手算出 KV cache 大小,这里先记住结论:KV 头越少,推理越省显存。
6. MLP / FFN(前馈网络)
一句话:attention 负责”token 之间交换信息”,MLP 负责”每个 token 自己消化信息”。
内部做了什么:两层线性 + 激活函数。标准配置是中间维度扩大到 4×:
1 | x (d_model) ──W_up──> z (4×d_model) ──GELU──> 非线性 ──W_down──> y (d_model) |
系统类比:attention = 集群里的节点互相发消息(all-to-all 通信);
MLP = 每个节点拿到消息后自己做本地计算(并行度高、通信为零)。
MLP 是参数大户:Llama-7B 里约 2/3 参数在 MLP,attention 只占约 1/3。
这也是为什么 MoE(后面讲)主要换掉的是 MLP 层。
7. LayerNorm / RMSNorm(归一化)
一句话:把每层输出”拉回”到稳定尺度,让深层网络训练不炸。
内部做了什么:对每个 token 的向量(按特征维)算均值/方差做标准化,
再乘可学习的 γ 加 β;RMSNorm 只按均方根缩放、不减去均值(省计算,效果几乎一样,
Llama/Qwen 标配)。注意不是 batch 维度——和 CNN 里的 BatchNorm 完全不同。
系统类比:像把每个节点的负载(激活值)归一化到标准范围,避免某些节点数值
过大导致梯度爆炸/消失——相当于给深水区降压,防止管线某段数值溢出。
8. 把 Block 串起来:一个 Transformer Layer 的完整前向
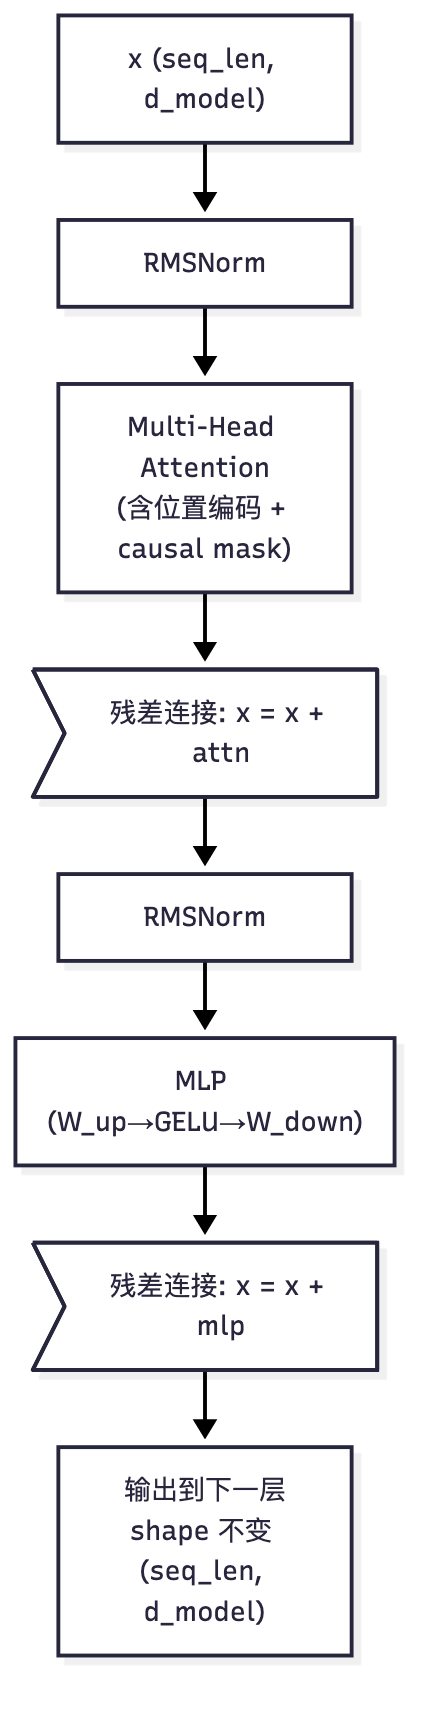
记忆点:
- 每层输入输出 shape 都不变 → 可以堆 N 层(Llama-3-8B 是 32 层);
- 残差连接 = 高速公路:让梯度能越过深层直接回传(防止梯度消失);
- 所以”模型参数量 ≈ 层数 ×(attention参数 + MLP参数)”,
大概估算:7B 模型 ≈ 32 层 × ~2.2 亿参数/层。
9. Loss(交叉熵):训练的目标函数
一句话:模型输出”下一个词的概率分布”,loss 衡量它和真实答案差多少。
1 | 模型输出 logits (vocab_size,) |
系统类比:像监控告警——模型”预测错了”会产生 error signal(loss),
梯度就是把这个 error 沿计算图回传、分摊给每个参数(下一节)。
10. Forward 与 Backward(前向传播 / 反向传播)
Forward(前向):数据从输入流到 loss,纯计算,期间要保存激活值(中间结果)
供反向用——这就是训练显存里”激活”那一块的来源。
Backward(反向):从 loss 出发,按链式法则把梯度从最后一层一路传回第一层,
每个参数都会得到一个”你对本步 loss 负多大责任”的数字。
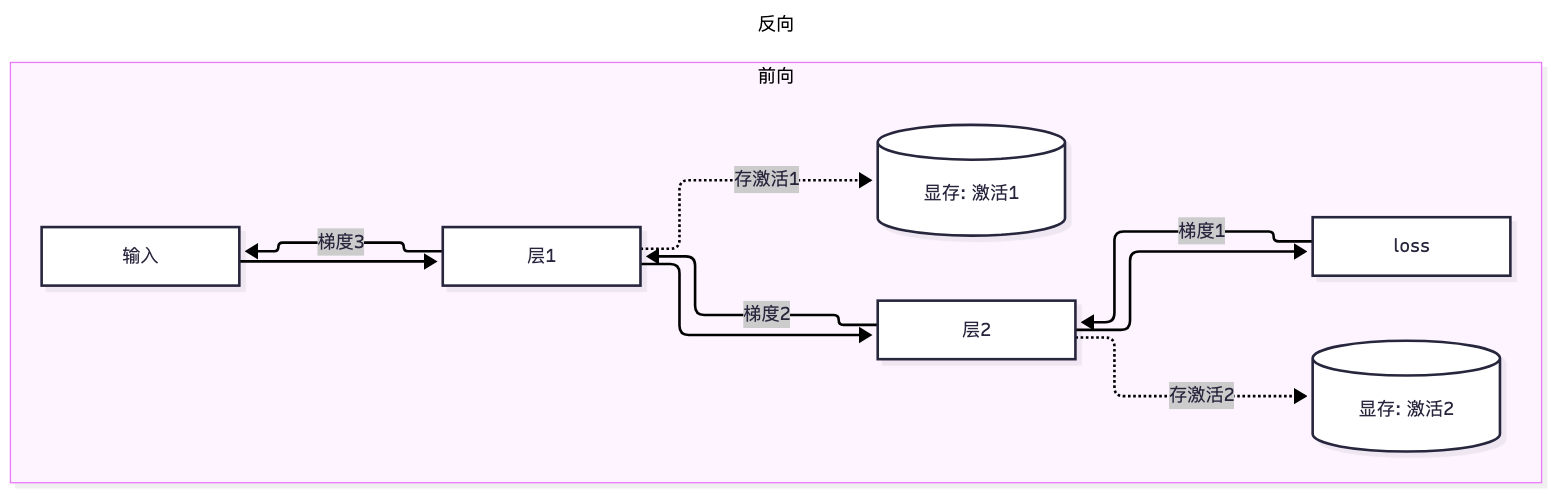
系统类比:前向 = 流水线生产;反向 = 质量追溯——
每个工位(层)根据”产品缺陷(loss)”往回算自己环节的偏差贡献。
反向时需要重放前向的激活值,所以这是一次”穿越时空”的计算——
这也是 activation checkpointing(重算激活换显存)这类技术存在的背景。
11. Gradient(梯度)
一句话:loss 对某个参数的偏导数——“这个参数往哪个方向调、调多少,能最快降低 loss”。
1 | L(loss) 对参数 θ 求偏导: ∂L/∂θ = g |
系统类比:下山找最低点。你站在山上(当前 loss),梯度告诉你怎么走最陡的下坡
(最速下降);学习率是每次迈的步子大小——步子太大(lr 太大)会越过谷底震荡,
太小则走得太慢。训练就是反复”所有参数一起迈一小步”,直到 loss 降到谷底。
12. Optimizer 与 Optimizer State(优化器状态)— 显存大头
一句话:更新参数需要优化器(默认 Adam),Adam 除了权重还要维护两份额外状态:
一阶矩 m(动量)和二阶矩 v(历史梯度平方的均值)。
1 | 每个参数在训练时占用显存: |
为什么这个数字重要:
- 推理:模型 7B 权重 FP16 = 7B × 2 字节 = 14 GB,单卡可装;
- 训练:同样 7B 模型 + Adam = 7B × 16 字节 = 112 GB,单卡根本装不下 → 这就是
训练必须做显存分片(ZeRO/FSDP,见词汇图鉴②)的根本原因。
系统类比:16B/参数 ≈ 训练态的”全量副本×4”(权重、梯度、动量、方差各一份)。
分布式训练里省显存,本质就是”谁也别保存全量副本,大家分着存、用时再凑”——
这就是下一份图鉴的核心。
13. 收尾:显存总账
单卡训练一个模型需要:
1 | 权重 (2B) + 梯度 (2B) + 优化器状态 (12B) + 激活 (取决于 batch×seq×层数) |
- 激活值 = batch_size × seq_len × d_model × 层数 × 若干倍的中间量,
这是训练大 batch / 长序列时显存爆炸的另一大头(与参数无关的部分); - 上面 16B/参数估算的是”参数相关”部分,激活另算。
记住三个公式(后面 Phase 1 W4 会实测验证):
- 推理权重显存 ≈ 参数量 × 精度字节数
- 训练参数显存 ≈ 参数量 × 16B(Adam,bf16 训练)
- 激活显存 ≈ 正比于 batch × seq_len × 层数